[컴퓨터 구조] 명령어 집합 분류 및 주소 지정 방식
2026.10.24 · 14분 읽기 · 조회 0
목차
1. 피연산자의 수와 명령어 집합컴퓨터 방식과 피연산자 수각 컴퓨터의 폰노이만 트래픽 비교누산기 컴퓨터A-COM의 명령어 목록A-COM의 명령어 구성A-COM의 트래픽 분석스택 컴퓨터S-COM의 명령어 목록S-COM의 명령어 구성S-COM의 프로그램S-COM의 트래픽 분석메모리-메모리 컴퓨터M-COM의 명령어 목록M-COM의 명령어 구성M-COM의 트래픽 분석범용 레지스터 컴퓨터범용 레지스터 컴퓨터 R-COMR-COM의 명령어 목록R-COM의 명령어 구성R-COM의 트래픽 분석레지스터 사용과 트래픽의 관계2. 명령어와 메모리메모리 속성주소 해상도메모리 정렬엔디언(endian) 방식3. 주소 지정 방식0-단계 주소 지정1-단계 주소 지정2-단계 주소 지정4. 복잡도에 따른 명령어 집합CISC vs RISCRISC (Reduced Instruction Set Computer)RISC 와 CISC의 전망
1. 피연산자의 수와 명령어 집합
컴퓨터 방식과 피연산자 수
- 누산기 컴퓨터: 1-주소 명령어
- 스택 컴퓨터: 0-주소 명령어
- 메모리-메모리 컴퓨터: 2-주소 혹은 3-주소 명령어
- 범용 레지스터 컴퓨터: 2-주소 혹은 3-주소 명령어
각 컴퓨터의 폰노이만 트래픽 비교
- 2차 방정식:
y = ax^2 + bx + c
가정:
- 연산 부호: 8비트 (1바이트)
- 메모리 주소: 16비트 (2바이트)
- 데이터 크기: 32비트 (4바이트)
누산기 컴퓨터
- 1960년대 이전 컴퓨터
- 데이터 저장을 위한 누산기(Accumulator) 레지스터 사용
->Acc = f(Acc, x): 누산기가 소스이자 목적지
->누산기: 묵시적 피연산자,메모리 x: 명시적 피연산자
A-COM의 명령어 목록
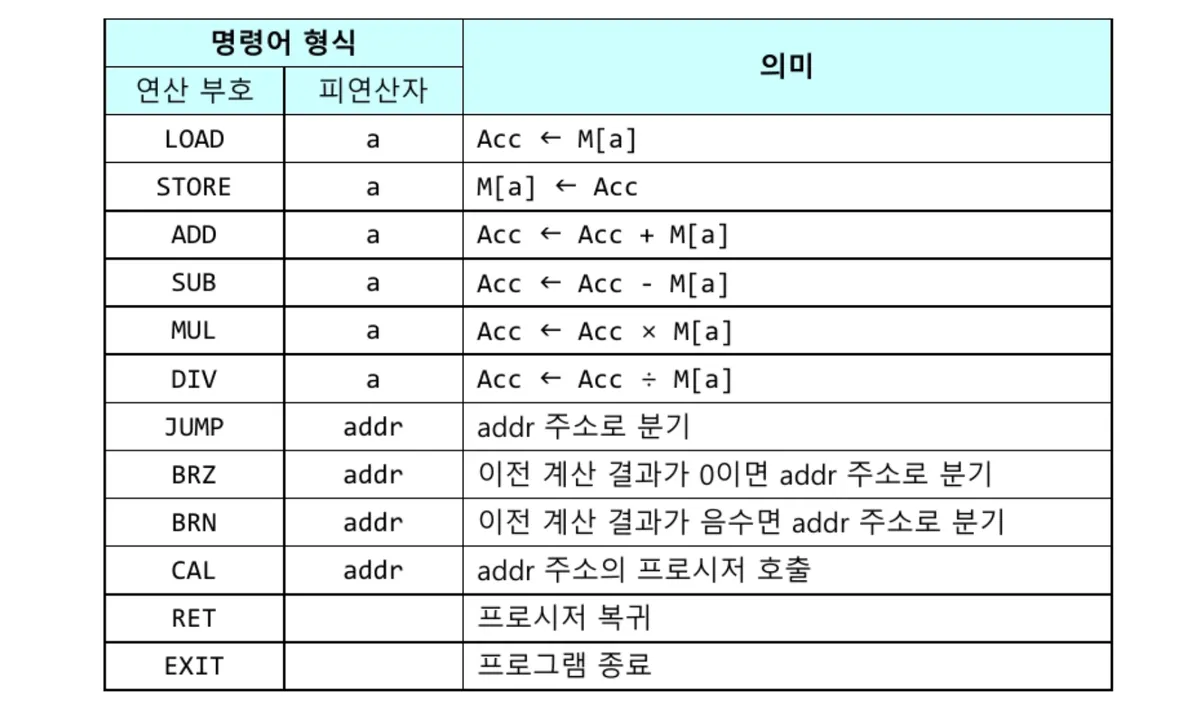
A-COM의 명령어 구성
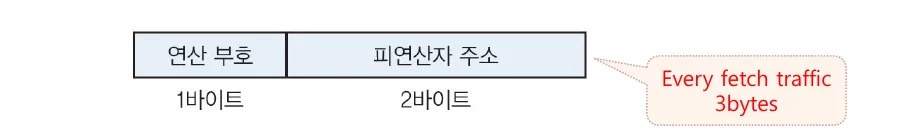
- 연산부호 (1바이트) + 피연산자 주소 (2바이트) = 3 바이트
-> 명령어를 가져올 때 마다 3바이트(fetch traffic) - 실행할 때 메모리 데이터 4바이트를 읽거나 씀.
->한 명령어 트래픽 = 3 + 4 = 7바이트. A-COM은 모든 명령어가 7바이트.
A-COM의 트래픽 분석
폰노이만 트래픽 = 명령어 트래픽 + 데이터 트래픽
- y = a·x² + b·x + c 를 계산하는 9줄 프로그램 일 때,
| 명령어 | 의미(누산기) | 트래픽(명령어 + 데이터) |
|---|---|---|
| LOAD a | a | 3 + 4 = 7 |
| MUL x | a·x | 7 |
| MUL x | a·x² | 7 |
| STORE y | y ← a·x² | 7 |
| LOAD b | b | 7 |
| MUL x | b·x | 7 |
| ADD c | b·x + c | 7 |
| ADD y | a·x² + b·x + c | 7 |
| STORE y | y ← 결과 | 7 |
- 트래픽 합계 = 명령어 27 + 데이터 36 = 63바이트
-> 중간 결과y를Acc하나에 담을 수 없어서STORE후 다시ADD로 불러온다.
불필요한 메모리 왕복이 트래픽을 늘린다.
스택 컴퓨터
- 1960~1970년대 컴퓨터
- CPU 내부에서 데이터 저장을 위해 Stack 사용
-> Stack 최상위에 위치한 1~2개 데이터를 묵시적 피연산자로 사용
-> 최근 연산한 데이터는 Stack의 최상위에 저장 - Stack 명령어
->push a,pop a,add
S-COM의 명령어 목록
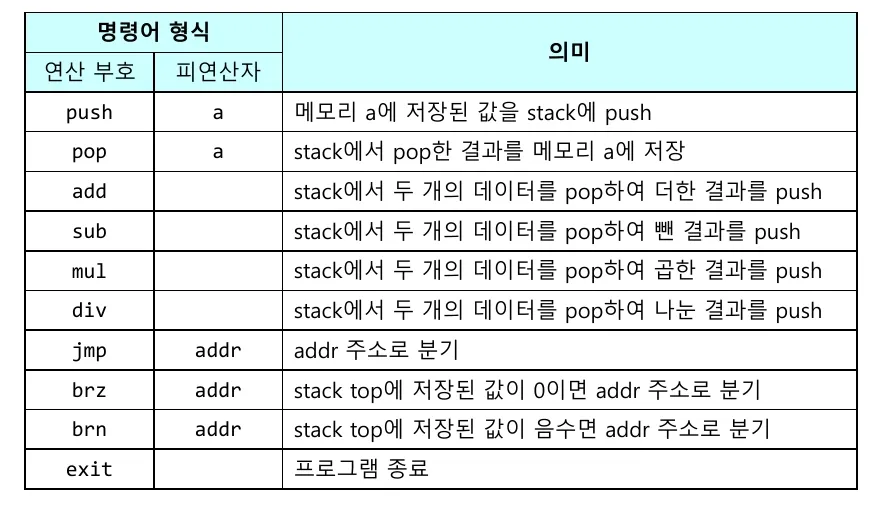
push a,pop a는 메모리 주소를 가진다.add,sub,mul,div는 피연산자가 없고, 스택에서 두 개를pop해 계산한 결과를push한다.
S-COM의 명령어 구성
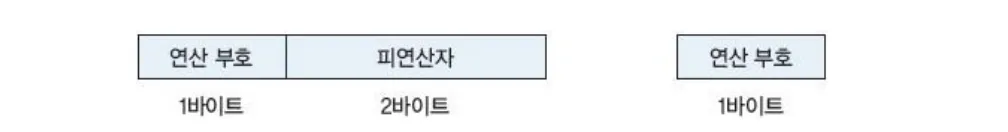
push a,pop a: 명령어 3바이트 + 데이터 4바이트 =7바이트mul,add: 명령어 1바이트 + 데이터 0바이트 =1바이트
S-COM의 프로그램
y = ax^2 + bx + c계산
| 명령어 | 스택 변화(왼쪽이 맨 위) |
|---|---|
| push a | a |
| push x, push x | x, x, a |
| mul | x², a |
| mul | a·x² |
| push b, push x, mul | b·x, a·x² |
| push c, add | b·x + c, a·x² |
| add | a·x² + b·x + c |
| pop y | y ← 맨 위 값 |
- 후위표기식을 계산하는 것과 같다.
S-COM의 트래픽 분석
| 명령어 | 의미 | 폰노이만 트래픽 (명령어 트래픽 + 데이터 트래픽) |
|---|---|---|
| push a | tos: M[a] | 3 + 4 = 7B |
| push x | tos: M[x], M[a] | 3 + 4 = 7B |
| push x | tos: M[x], M[x], M[a] | 3 + 4 = 7B |
| mul | tos: M[x]², M[a] | 1 + 0 = 1B |
| mul | tos: M[a]×M[x]² | 1 + 0 = 1B |
| push b | tos: M[b], M[a]×M[x]² | 3 + 4 = 7B |
| push x | tos: M[x], M[b], M[a]×M[x]² | 3 + 4 = 7B |
| mul | tos: M[b]×M[x], M[a]×M[x]² | 1 + 0 = 1B |
| push c | tos: M[c], M[b]×M[x], M[a]×M[x]² | 3 + 4 = 7B |
| add | tos: M[b]×M[x] + M[c], M[a]×M[x]² | 1 + 0 = 1B |
| add | tos: M[a]×M[x]² + M[b]×M[x] + M[c] | 1 + 0 = 1B |
| pop y | y ← tos의 내용 | 3 + 4 = 7B |
| 트래픽 합계 | 26 + 28 = 54B |
메모리-메모리 컴퓨터
- 1970~80년대 컴퓨터
- CPU 내부에 기억장치가 없는 컴퓨터
-> 모든 데이터가 메모리에서 CPU를 경유하여 메모리로 전송
-> 명령어의 피연산자 필드에 메모리 전체 주소를 명시 - 2-주소 명령어와 3-주소 명령어
-> 2-주소 명령어:add a, b<-M[a] <- M[a] + M[b]
-> 3-주소 명령어:add a, b, c<-M[a] <- M[b] <- M[c]
M-COM의 명령어 목록
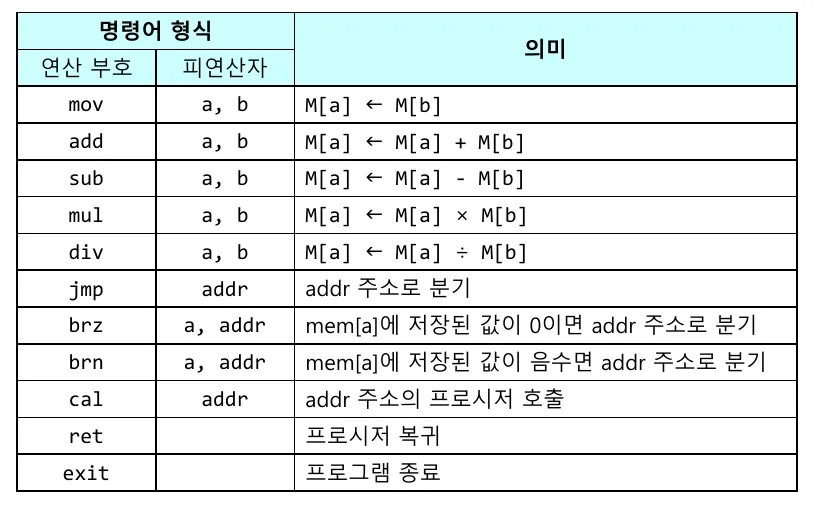
- 모든 연산의 피연산자가 메모리 주소라서 명령어가 길어진다.
M-COM의 명령어 구성
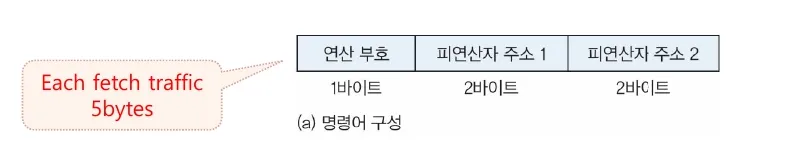
- 연산 부호 (1바이트) + 주소 2개 (4바이트) = 5바이트
- 데이터 트래픽:
->mov a, b:하나는 읽고, 하나는 쓰므로 8바이트
->add/mul a, b: a와 b를 읽고, 결과를 a에 쓰므로 12바이트
M-COM의 트래픽 분석
y = ax^2 + bx + c계산
| 명령어 | 의미 | 폰노이만 트래픽 (명령어 트래픽 + 데이터 트래픽) |
|---|---|---|
| mov y, a | M[y] ← M[a] | 5 + 8 = 13B |
| mul y, x | M[y] ← M[a] × M[x] | 5 + 12 = 17B |
| mul y, x | M[y] ← M[a] × M[x]² | 5 + 12 = 17B |
| mov t, b | M[t] ← M[b] | 5 + 8 = 13B |
| mul t, x | M[t] ← M[b] × M[x] | 5 + 12 = 17B |
| add y, t | M[y] ← M[a] × M[x]² + M[b] × M[x] | 5 + 12 = 17B |
| add y, c | M[y] ← M[a] × M[x]² + M[b] × M[x] + M[c] | 5 + 12 = 17B |
| 트래픽 합계 | 35 + 76 = 111B |
- 명령어 수는 가장 적지만 트래픽이 가장 크다.
범용 레지스터 컴퓨터
- 1970년대 이후
- CPU 내부에 데이터 저장을 위한 범용 레지스터를 사용하는 컴퓨터
-> 모든 레지스터의 접근 시간이 동일하다
-> 순서에 상관 없는 임의 접근이 가능하다.
-> 레지스터를 명시적 피연산자로 사용한다. - 2-주소 명령어와 3-주소 명령어
-> 2-주소 명령어:add r1, r2(r1 <- r1 + r2)
-> 3-주소 명령어:add r1, r2, r3(r1 <- r2 + r3)
범용 레지스터 컴퓨터 R-COM
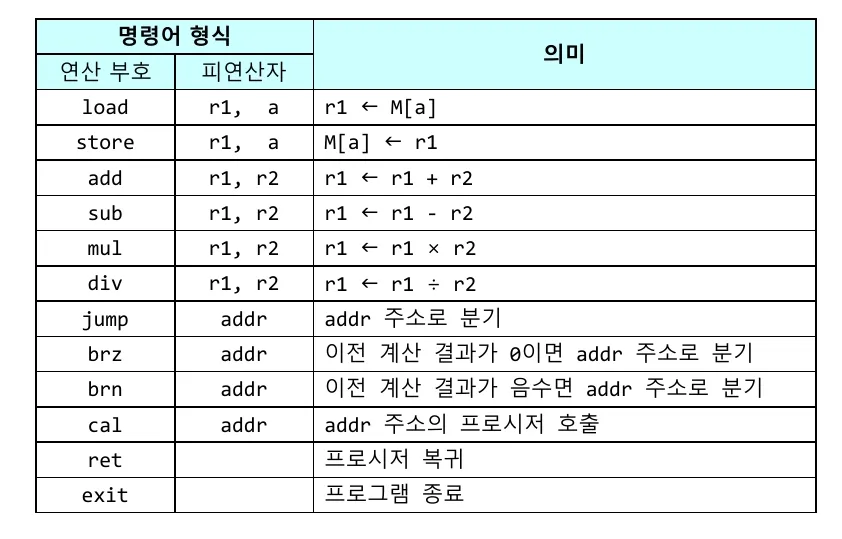
- 적재-저장 명령어 컴퓨터(load-store machine)
-> 적재 명령어와 저장 명령어만 메모리에 접근할 수 있도록 제한하는 컴퓨터
-> 적재(load) :load r1, a(r1 <- M[a])
-> 저장(store) :store r1, a(M[a] <- r1) - 추가 가정
-> 2-주소 명령어
-> 16개의 레지스터 사용: r0 ~ r15
-> 적재-저장 명령어 컴퓨터
R-COM의 명령어 목록
R-COM의 명령어 구성
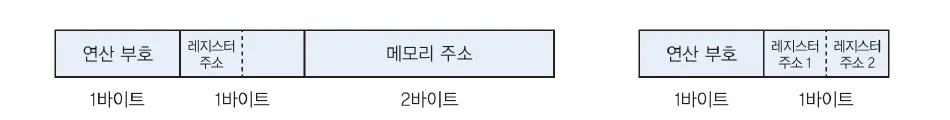
- 레지스터 주소 : 1바이트 (0.5B)
- 연산부호 1바이트, 메모리 주소 2바이트
load r1, x: 명령어 (4바이트) + 데이터 (4바이트) = 8바이트mul r2, r1: 명령어 (2바이트) + 데이터 (0바이트)
R-COM의 트래픽 분석
y = ax^2 + bx + c계산
| 명령어 | 의미 | 폰노이만 트래픽 (명령어 트래픽 + 데이터 트래픽) |
|---|---|---|
| load r1, x | r1 ← M[x] | 4 + 4 = 8B |
| load r2, a | r2 ← M[a] | 4 + 4 = 8B |
| load r3, b | r3 ← M[b] | 4 + 4 = 8B |
| load r4, c | r4 ← M[c] | 4 + 4 = 8B |
| mul r2, r1 | r2 ← M[a] × M[x] | 2 + 0 = 2B |
| mul r2, r1 | r2 ← M[a] × M[x]² | 2 + 0 = 2B |
| mul r3, r1 | r3 ← M[b] × M[x] | 2 + 0 = 2B |
| add r3, r2 | r3 ← M[a] × M[x]² + M[b] × M[x] | 2 + 0 = 2B |
| add r4, r3 | r4 ← M[a] × M[x]² + M[b] × M[x] + M[c] | 2 + 0 = 2B |
| store r4, y | M[y] ← r4의 내용 | 4 + 4 = 8B |
| 트래픽 합계 | 30 + 20 = 50B |
레지스터 사용과 트래픽의 관계
명령어 트래픽 감소
- 메모리를 위한 긴 주소 대신에 레지스터의 짧은 주소로 피연산자를 명시해 명령어 길이가 줄어든다
- 누산기의 경우 피연산자를 생략해 명령어 길이를 줄인다
데이터 트래픽 감소
- 반복적으로 사용되는 피연산자를 CPU 내부 레지스터에 보관해서 데이터 이동 개수를 줄인다
- mov 명령의 데이터 이동 2개 -> load/store 명령의 데이터 이동 1개
- add/mul 명령의 데이터 이동 3개 -> 레지스터 이용으로 데이터 이동 0개
| 컴퓨터 | 명령어 개수 | 명령어 트래픽 | 데이터 트래픽 | 트래픽 합계 |
|---|---|---|---|---|
| 누산기 컴퓨터 A-COM | 9 | 27 | 36 | 63 |
| 스택 컴퓨터 S-COM | 12 | 26 | 28 | 54 |
| 메모리-메모리 컴퓨터 M-COM | 7 | 35 | 76 | 111 |
| 범용 레지스터 컴퓨터 R-COM | 10 | 30 | 20 | 50 |
2. 명령어와 메모리
메모리 속성
워드(word)
- 컴퓨터 내부에서 취급되는 정보 단위
- CPU가 한 번에 처리할 수 있는 데이터 크기
- 현재 32비트 또는 64비트 사용
주소(address)
- 주소 지정 단위로 메모리 저장공간을 구분하는 일련 번호
주소 지정 단위(addressable unit)
- 주소 해상도(address resolution): 아키텍처가 명시할 수 있는 정보의 최소 단위
- 보통 byte 단위 사용
주소 해상도
주소 해상도 크기 특성
- 주소 해상도가 작으면, 주소 표현에 많은 비트가 필요하다
- 주소 해상도가 크면, 명령어 표현에 낭비되는 부분이 발생한다
주소 해상도와 메모리 저장 용량
- 주소 해상도 R, 주소 비트가 n이면, 메모리 최대 저장 용량은
2^n * R - 주소 해상도 1byte, 주소 비트가 16이면, 메모리 최대 저장 용량은
2^16 * 1 = 64kbyte
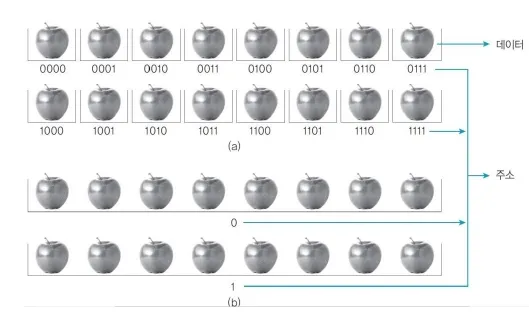
-> (a) : 주소 해상도 1byte , 주소비트 4bit -> 최대 저장 용량은 16byte
-> (b) : 주소 해상도 8byte, 주소비트 1bit -> 최대 저장 용량은 16byte
메모리 정렬
정렬된 데이터(aligned memory)
- 실행 속도를 높이기 위해 명령어와 데이터를 강제로 정렬하는 방식
- 2(or 4)바이트로 구성된 명령어, 데이터는 2(or 4)의 배수로 시작되는 주소를 가짐
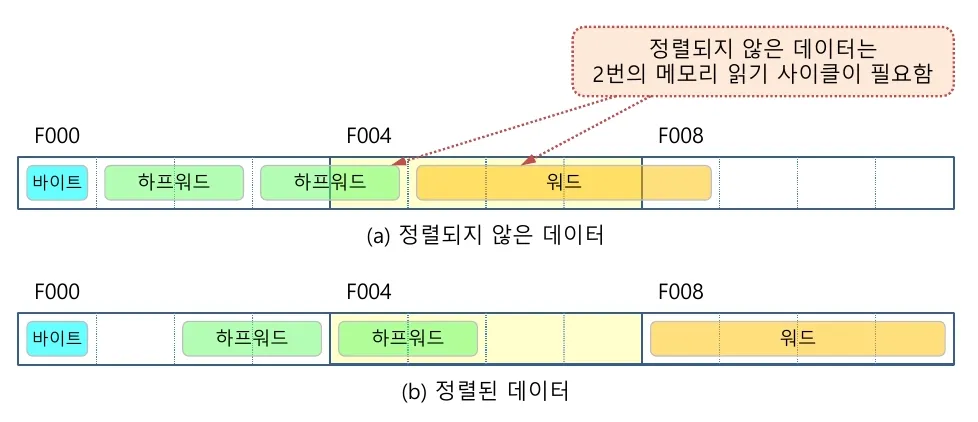
-> 2바이트 데이터(하프워드) : 2의 배수 주소에서 시작
-> 4바이트 데이터(워드) : 4의 배수 주소에서 시작
-> 1바이트(바이트): 아무데나 가능
엔디언(endian) 방식
여러 개의 연속된 대상을 1차원 공간에 배열하는 방법
- 32비트 컴퓨터일 경우, 4바이트를 배열하는 방법
- 엔디언 방식이 다른 컴퓨터 사이의 데이터 교환 시 주의가 필요함
빅 엔디언(big endian) 과 리틀 엔디언(little endian)
- Word 단위 데이터가 메모리에 저장되는 순서가 다르다
OAOBOCOD라는 데이터를 저장할 때,
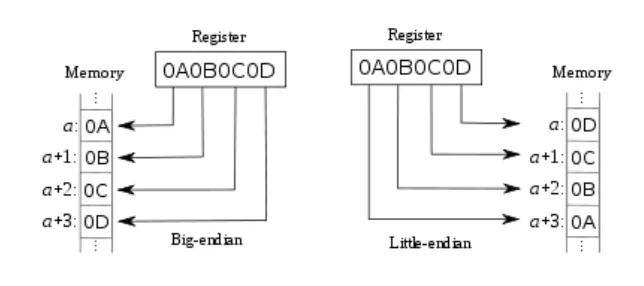
- 빅 엔디언: 수가 큰 부분부터 저장
- 리틀 엔디언: 수가 작은 부분부터 저장
3. 주소 지정 방식
- 명령어의 피연산자 필드로 데이터의 유효 주소(effective address)를 결정하는 방법
- 최근 아키텍쳐는 효율적인 데이터 위치 지정을 위해 다양한 방식을 제공한다
- 몇 단계를 거쳐 데이터에 접근하는가로 구분한다. 단계가 깊을수록 참조 시간은 오래 걸리지만 더 많은 데이터를 다양한 방법으로 보관할 수 있다.
유효주소 계산식 표기
r: 레지스터 주소Reg[x]: 레지스터 x의 내용a: 메모리 주소M[x]: 메모리 x번지의 내용ea: 참조되는 데이터를 포함하는 실제 주소, 유효 주소
0-단계 주소 지정
- 데이터 위치 파악에 특별한 과정이 없는 방식
- 즉치 주소지정(immediate): 피연산자 필드에 데이터가 직접 들어 있음
->ADD #3: 누산기에 3을 직접 더함 - 묵시 주소 지정(implied): 누산기나 PC처럼 정해진 기억장치에 데이터가 있어 위치를 명시할 필요가 없음
-> S-COM의ADD: 대상이 이미 정해져 있음
1-단계 주소 지정
- 유효 주소를 확정하는데 계산이나 읽기를 1회 하는 방식. 명령어의 피연산자 필드를 주소로 쓴다
- 레지스터 직접 주소 지정,
ea = r
->ADD R1, R2 - 직접 주소 지정,
ea = a
->LOAD R1, 500
2-단계 주소 지정
- 유효 주소를 확정하는데 계산이나 읽기를 2회 하는 방식
레지스터 간접 주소 지정
ea = Reg[r]- 레지스터의 내용은 데이터를 위한 메모리의 주소를 명시
load r2, (r1)->Reg[r1]에는 메모리 주소800이 들어있음,M[800]내의 데이터를 또 가져와야 함. 즉,데이터in메모리 주소in레지스터총 두 차례 읽어야 함.
메모리 간접 주소 지정
ea = M[a]- 데이터가 있는 메모리의 주소를 명시
- 메모리 주소 공간이나 메모리 용량의 제약을 해결한다. 두 번의 메모리 접근 필요
load r1, (500)-> 500에는 데이터의 주소가 있음 -> 그 주소에 진짜 데이터가 있음
변위 주소 지정
ea = Reg[r] + a- 명령어의 피연산자 필드 2개를 쓴다.
메모리 주소 a,레지스터 r에 든 주소 - 이 둘을 더해 유효 주소를 만든다
a = 1000,Reg[r] = 4이면,ea = 1004.
기준 주소에서 일정 거리만큼 떨어진 곳을 가리킨다.
변위 주소 지정 방법 응용 1: 색인 주소 지정
- 메모리 주소 1에 배열의 시작 주소를 베이스로 지정하고,
index 변위를 레지스터 값(메모리 주소2)로 지정하여 손쉽게 배열원소에 접근 - 배열
A가 1000번지 부터 시작, 1칸이 4바이트면, 주소는a = 1000,Reg[r]의 값은 4씩 늘려가면A[0],A[1]... 이렇게 읽을 수 있음
변위 주소 지정 방법 응용2: 베이스 주소 지정
- 메모리 주소1에 모듈 안의 상대 주소, 레지스터에 재배치 주소(베이스) 를 두어 모듈을 쉽게 재배치
a= 모듈 안의 위치는 고정,r= 레지스터로 시작점을 바꿈
PC 상대 주소 지정
- PC를 베이스로 써서 상대 주소를 지정한다.
- PC를 명시할 필요가 없으니 상대주소를 위한 피연산자 필드 하나만 쓴다.
- 주로 분기 명령어에서 사용한다. 피연산자에는 오프셋만 올린다.
- PC가
0106일 때,BRZ +10이면 분기 목적지는PC + 10이다.
정리
| 방식 | 유효 주소 | 메모리 접근 수 |
|---|---|---|
| 즉치 | (데이터가 명령어 안에) | 0 |
| 레지스터 직접 | ea = r | 0 (레지스터) |
| 직접 | ea = a | 1 |
| 레지스터 간접 | ea = Reg[r] | 1 |
| 메모리 간접 | ea = M[a] | 2 |
| 변위(색인, 베이스, PC 상대) | ea = Reg[r] + a | 1 |
4. 복잡도에 따른 명령어 집합
초기 컴퓨터의 문제점
- 메모리가 매우 비싸고 느려서 코드 밀도를 높여 메모리를 아끼려고 했다.
- 소프트웨어 기술이 발달하지 않아 강력한 명령어가 필요할거라고 생각
-> CISC 구조가 인기
CISC는 필연적으로 가변 명령어 형식 사용
- 주소 지정 방식이 많아서 명령어를 해독하기 전엔 길이를 알 수 없다.
- 명령어 인출 속도와 데이터 전송 효율이 떨어지고, 제어장치가 복잡해 파이프라인 구현이 어렵다
CISC vs RISC
CISC의 명령어 활용성
- 복잡한 명령어는 사용 빈도가 매우 낮고, 일부 데이터 형식은 거의 쓰지 않는다.
- 컴파일러도 CISC의 강력한 명령어를 충분히 쓰지 않는다.
발상의 전환
- 비효율적인 복합 명령어보다 기본 명령어를 잘 조합하자.
- 메모리 값이 내려가 코드 밀도의 중요성이 줄었고, 메모리 속도가 올라 폰노이만 병목의 영향도 줄었다.
-> RISC 구조의 등장
RISC (Reduced Instruction Set Computer)
RISC의 특징
- 단순 명령어 형식, 명령어 종류 최소화, 고정 길이 명령어 사용
- 적재-저장 구조. 제한된 주소 지정 방식, 하버드 아키텍쳐(명령어 캐시, 데이터 캐시)
RISC의 장점
- 제어 장치가 간단해져 사이클 기간이 짧아지고 파이프라이닝의 효과적 구현 가능
- 명령어 집합이 단순해져 효율적인 최적화 컴파일러를 만들 수 있다
RISC 와 CISC의 전망
- 칩 밀도와 하드웨어 속도가 올라가면서 둘의 경계가 무너지고, 오늘날 컴퓨터는 두 구조의 장점을 통합하는 추세다.
| 구분 | RISC | CISC |
|---|---|---|
| 명령어 형식 / 길이 | 고정 | 가변 |
| 명령어 종류 | 적음 | 많음 |
| 적재-저장 구조 | 사용 | 미사용 |
| 주소 지정 방식 | 단순하고 소수 | 복잡하고 다수 |
| 회로 구성 | 단순 | 복잡 |
| 장점 | 구현 용이, 호환성 양호, 파이프라이닝에 효율적 적용 | 코드 밀도 양호 |
| 예 | MIPS, ARM, PowerPC | Intel x86, DEC VAX 11/780 |
초록
앱과 웹을 만들고, 직접 운영하며 기록합니다.
댓글
giscus로 동작하며 GitHub Discussions에 저장됩니다.