[컴퓨터 구조] 컴퓨터의 성능
2026.10.17 · 6분 읽기 · 조회 0
목차
컴퓨터의 성능
성능의 정의
- 컴퓨터의 성능은 곧 실행 속도이고, 두 가지 관점이 있다.
1. 응답 시간(실행 시간)
- 개인 사용자 관점. 내 작업이 얼마나 빨리 끝나는지
2. 처리율(throughput, 대역폭)
- 시스템 관리자 관점. 단위 시간에 몇 개를 처리하는지.
CPU 실행 시간
- 프로그램을 수행하는데 순수하게 사용된 시간
- 입출력이나 다른 프로그램의 실행 시간은 뺀다.
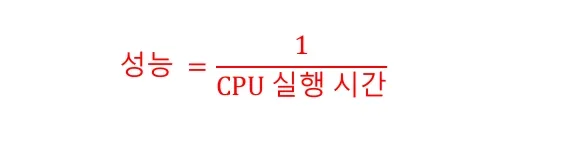
-> 시간이 짧을 수록 성능이 좋다.
컴퓨터 M1, 과 M2의 성능 비교
- 컴퓨터 M2 는 컴퓨터 M1 보다 성능이 n배 좋다.
- 컴퓨터 M1에 대한 컴퓨터 M2의 성능향상은 n이다.
- 컴퓨터 M1에 대한 컴퓨터 M2의 성능 비율은 n이다.
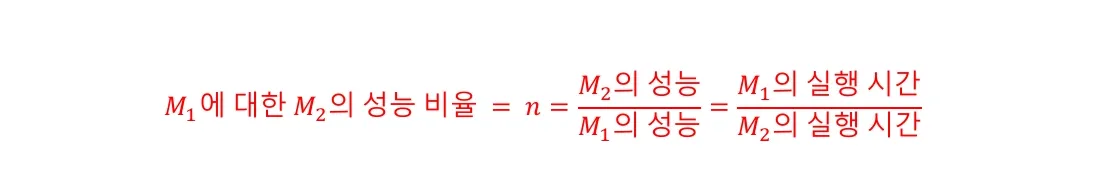
시스템 병렬화
- 프로세스를 병렬로 실행해 빠르게 하는 기법
- 병렬화 하지 못하고 순서대로 처리해야 하는 부분이 존재한다.
- 때문에 성능 향상은 순차 처리 부분에 의해 제한된다.
암달의 법칙(Laws of Gene Amdhal)
- 시스템의 일부분을 개선할 때 전체 시스템 성능이 얼마나 향상되는지 계산하는 방법
- 시스템 일부분 f를 병렬화 하여 성능을 n배 향상시켰을 때, 시스템 전체 성능 향상인 s는
1/(1-f)보다 더 커질 수 없다.("암달의 저주")
암달의 법칙 공식
- 시스템의 일부분
f를 병렬화하여 성능을n배 향상 - 나머지 부분
(1-f)는 그대로 두었다고 가정 - 성능 향상 전의 기계를
M1, 성능이 향상된 기계를M2라고 가정 - 시스템 전체 성능 향상은 s
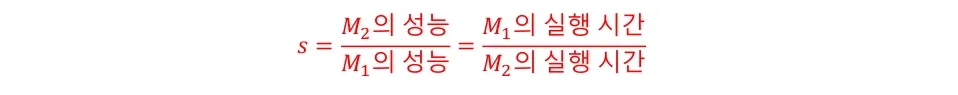
M1의 실행시간을 m이라고 할 때,M2의 실행시간은
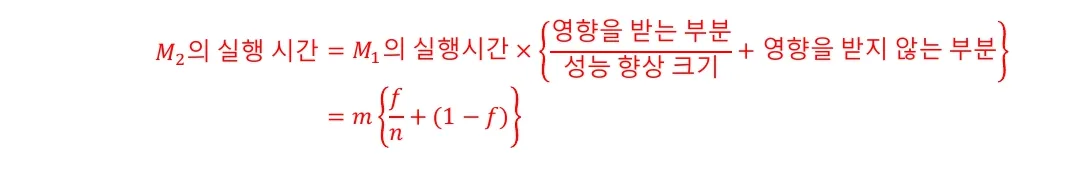
-> f가 n배만큼 빨라졌으니 f/n -> m x (빨라진 부분 시간 + 그대로인 부분 시간)
시스템 전체 성능 향상 s는
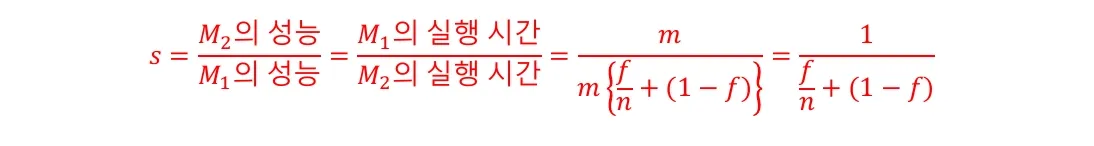
-> 이때, 병렬화를 무한히 적용하면
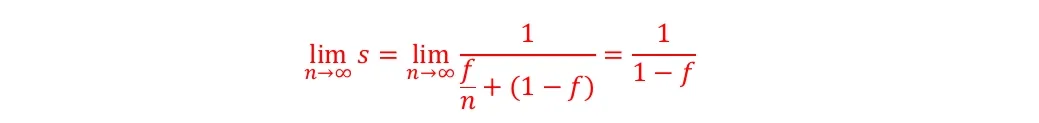
-> 결과적으로 시스템 전체 성능 향상 s는 개선되지 않은 부분의 역수가 된다.
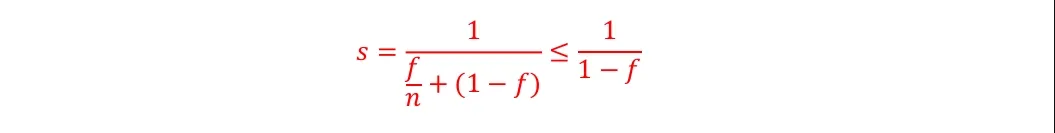
-> 결국 병렬화 불가능한 부분이 남아있다면 전체 속도 향상에는 한계가 있다.
암달의 법칙 예제
- 하나의 프로그램이 싱글코어 프로세서를 사용하면 20시간 소요
- 1시간 부분은 병렬화할 수 없고, 나머지 19시간 부분은 병렬화 가능
- 병렬화를 위한 프로세서 수에는 제한이 없음
- 이때, 시스템 전체 성능 향상인 s는 어떻게 될까?
-> f 는 향상된 부분이므로 19/20
-> s = 1/(1 - 19/20) = 1 / (1 / 20) = 20 이 된다.
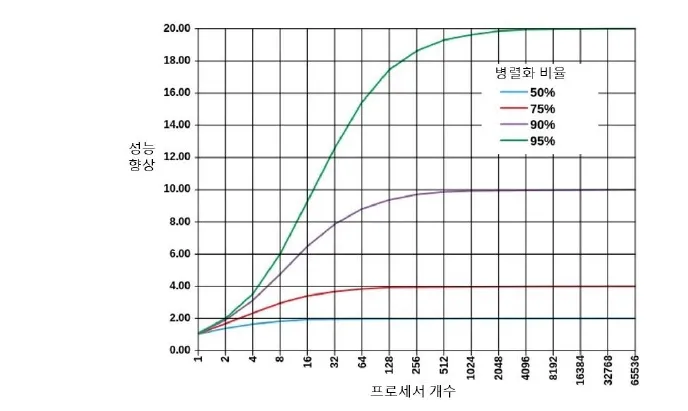 -> 프로세서를 아무리 늘려도 순서대로 해야하는 1시간은 줄지 않으니 20배의 향상이 한계이다.
CPU 성능 분석
성능에 영향을 미치는 요소
- CPU 성능을 평가할 때는 클록 속도(Clock Speed/Cycle) 가 중요하다.
- 하지만 클록 속도가 빠르다고 무조건 성능이 우수하다고는 할 수 없다.
- 동일한 CPU 구조일 때는 클록 속도가 3.0GHz인 CPU가 2.0GHz인 CPU보다 우수하지만. CPU 구조가 다르면 다른 요인도 살펴보아야 한다.
헤르츠
주파수나 진동수의 단위로 1초에 몇 번 진동하는 가를 의미, 초당 사이클(CPS)
정확한 시계의 초침은 1Hz
클록 속도 3.0GHz는 1초에 3,000,000,000번 클록이 발생한다는 의미
CPU 실행시간의 분해
- CPU의 성능은 프로그램 실행 시간으로 구분 가능
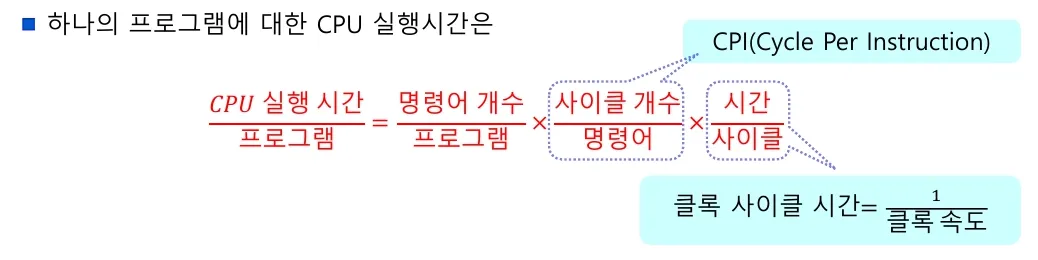
- 따라서 CPU 실행 시간은
-> CPI는 명령어마다 다르므로 평균 CPI를 사용
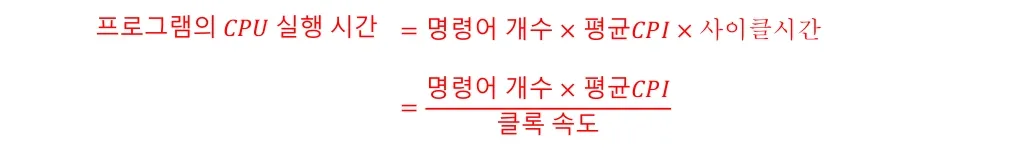
- 사이클 시간 =
1/클록속도 평균 CPI=사이클 개수(CPI) x 프로그램 내 비중(사용 빈도)프로그램의 CPU 실행 시간= (명령어 개수x평균 CPI) /클록 속도
예제 문제
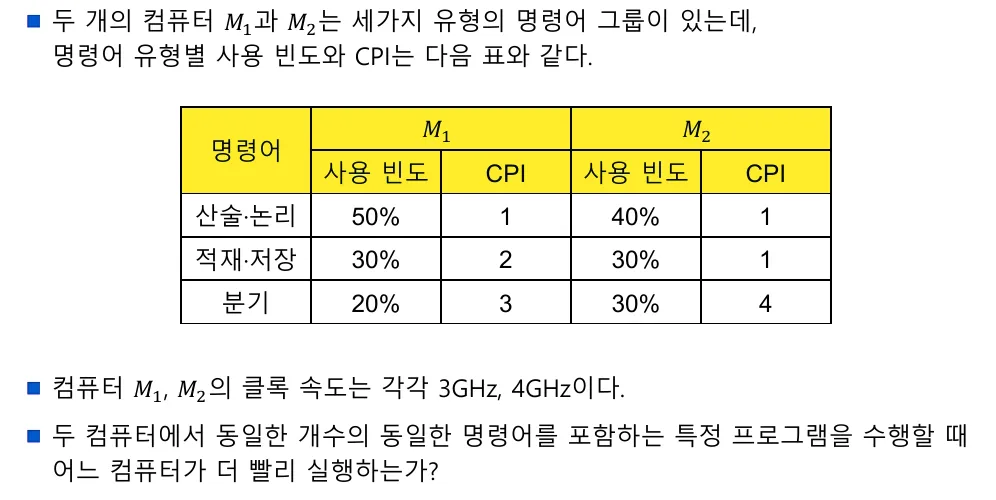
CPU 실행 시간 = (명령어 개수 X 평균 CPI) / 클록 속도
평균 CPI = (사용 빈도) X CPI

M1의 평균 CPI = (0.5 * 1) + (0.3 * 2) + (0.2 * 3) = 1.7 # M1이 더 좋음
M2의 평균 CPI = (0.4 * 1) + (0.3 * 1) + (0.3 * 4) = 1.9

명령어 개수는 같으므로 무시

M1 실행 시간 = 1.7 / 3GHz ≈ 0.56
M2 실행 시간 = 1.9 / 4GHz ≈ 0.47 # M2가 더 빠르다
성능에 영향을 미치는 요소의 분석
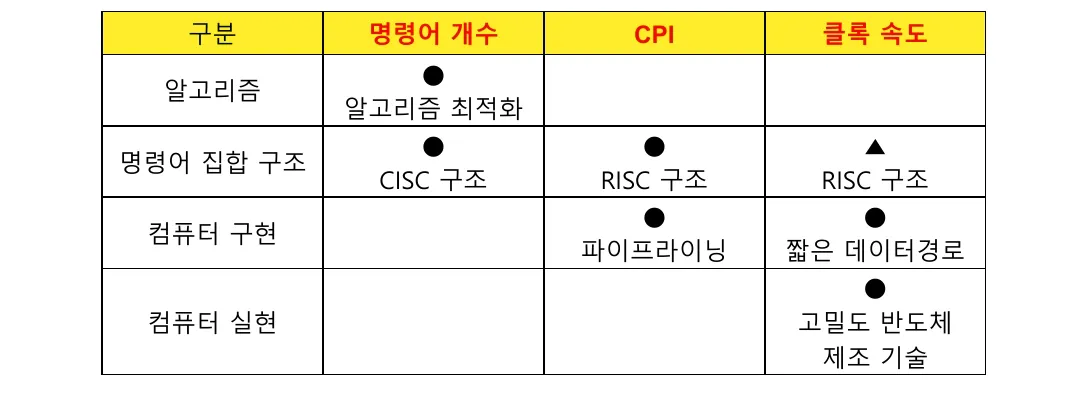
- CISC: Complex Instruction Set Computer, 복합 명령어 집합 구조
- RISC: Reduced Instruction Set Computer, 축약 명령어 집합 구조
아키텍쳐 수준
- CISC 구조: 프로그램 크기(명령어 수)가 줄어들지만 평균 CPI와 사아클 시간이 커진다
- RISC 구조: 명령어 개수가 늘어나지만 평균 CPI와 사이클 시간이 줄어든다
CISC
-> 명령어 하나가 여러가지 복잡한 동작을 한 번에 수행한다.
-> 복잡한 전용 명령어가 많아 프로그램의 전체 명령어 개수가 줄어든다.
-> 명령어가 복잡하기에 명령어 하나를 처리하는데 필요한 평균 CPI와 사이클 시간이 커진다.
인텔, AMD의 x86 / x64 CPU
RISC
-> 단순하고 꼭 필요한 필수 명령어만 남긴 단순화된 구조이다.
-> 단순 명령어 위주라 동일 작업을 할 때 필요한 전체 명령어 개수는 늘어난다.
-> 명령어가 단순하므로 평균 CPI와 사이클 시간을 대폭 줄일 수 있다.
-> 전력 소모가 적고 회로가 가벼워서 모바일이나 고효율 칩에 유리하다.
ARM 칩셋(스마트폰의 스냅드래곤, 애플의 M시리즈)
컴퓨터 구현
- 시스템을 병렬화 하면 평균 CPI가 줄어들지만 사이클 시간이 늘어날 수 있다.
컴퓨터 실현
- 반도체 칩 내부의 트랜저스터 집적도를 높이면 사이클 시간이 줄지만 비용이 높아진다.
2진수, 16진수 기초
진법
- k진법: 0 ~ (k-1)의 숫자를 사용하는 위치 기수법
-> k진수 (101)k =1 x k^2 + 0 x k^1 + 1 x k^0 - 2진법:
0,1의 숫자를 사용하는 위치 기수법 - 10진법:
0 ~ 9의 숫자를 사용하는 위치 기수법 - 16진법:
0 ~ 9,A ~ F의 숫자를 사용하는 위치 기수법
진법 변환: 10진수 -> 2진수
- 2로 계속 나누며 나머지를 기록한다
- 0이 나오면 나머지를 역순으로 적는다
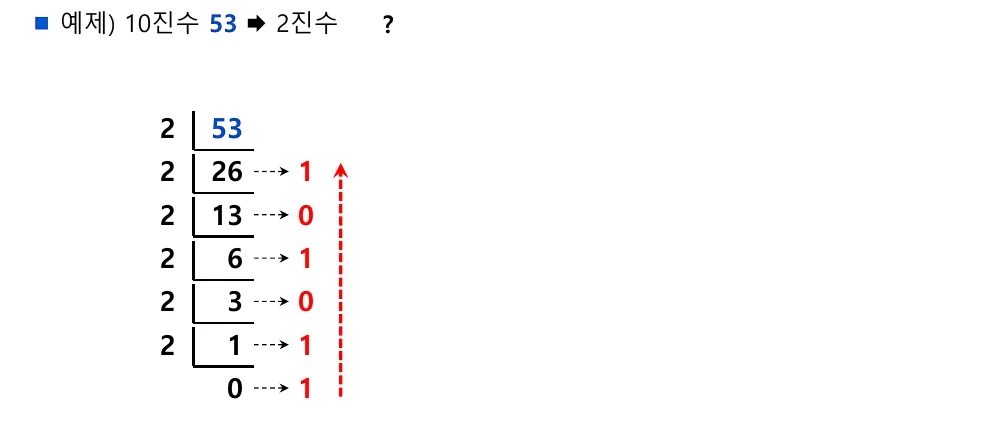
(53)10 -> (110101)2
진수 변환: 10진수 -> 2진수 소수점 이하
- 소수점 이하 부분에 계속 2를 곱하며 정수부분(0 or 1)을 기록한다.
- 소수점 이하가 1.0이 되면 멈추고 정방향으로 읽는다.
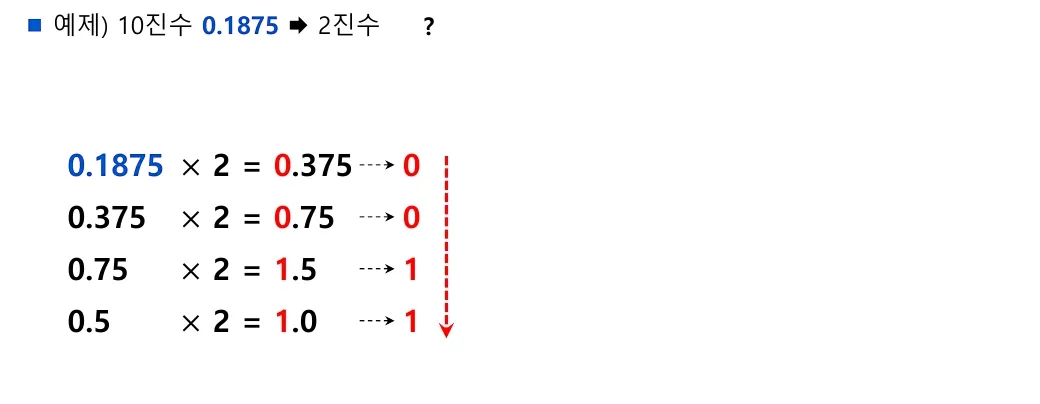
(0.1875)10 -> (0.0011)2
진수 변환: 2진수 -> 10진수
- 1이 있는 자리의 값만 더한다. 자리값은 우측부터 1, 2, 4, 8, 16... ->
2^(n-1)
-> (110101)2 =32 + 16 + 4 + 1= 53 - 소수점 오른쪽의 값은 좌측부터 1/2, 1/4, 1/8, 1/16... ->
2^(-n)
-> (1100.11)2 = 8 + 4 + 0.5 + 0.25
진수 변환: 10진수 -> 16진수
-
16으로 나눈 나머지를 기록하며 역순으로 읽는다.
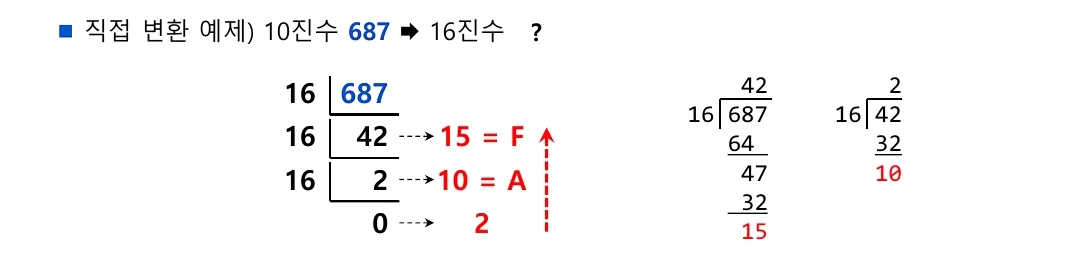
-
일반적으로 10진수 -> 2진수 -> 16진수 순으로 변환하면 더 간단하다.
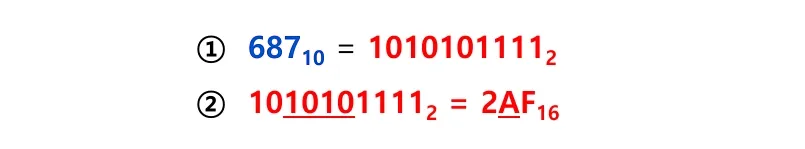
-> 2진수에서는 우측에서부터 4개씩 끊으면 된다. (10 / 1010 / 1111)2 -> (2 / A / F)16
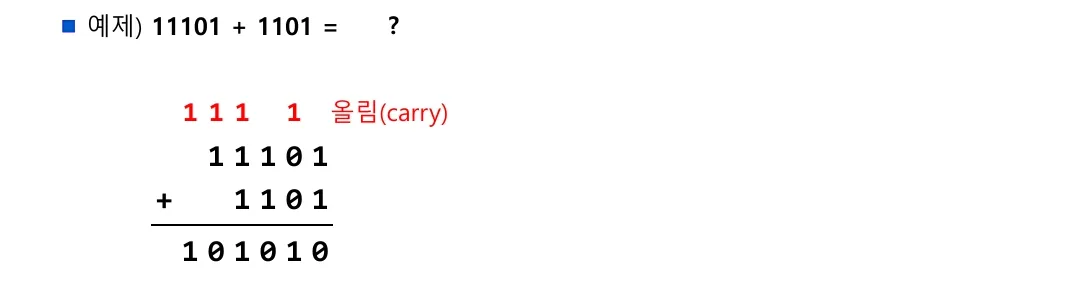
2진수 덧셈
0 + 0 = 01 + 0 = 11 + 1 = 10(carry)1+ 1 + 1 = 11(carry)
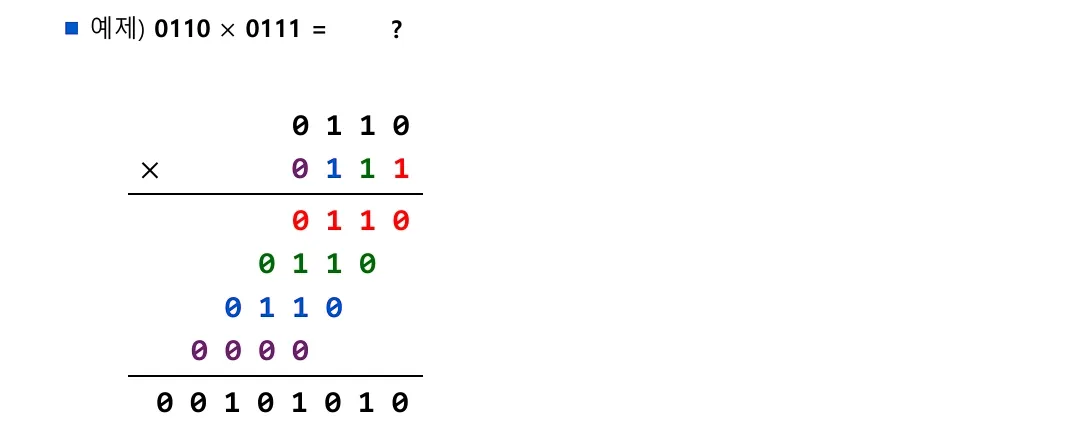
2진수 곱셈
- 10진수 곱셈과 같다.
앱과 웹을 만들고, 직접 운영하며 기록합니다.
댓글
giscus로 동작하며 GitHub Discussions에 저장됩니다.