[컴퓨터 구조] 명령어 집합
2026.10.18 · 13분 읽기 · 조회 0
목차
명령어 집합고급 언어(high-level language)어셈블리어기계 명령어(machine instruction)명령어 집합 구조(ISA, Instruction Set Architecture)명령어 집합 설계명령어 특성명령어란?명령어의 구성: 연산부호 + 피연산자명령어 길이 형식피연산자 수에 따른 명령어 형식3-주소 명령어 형식2-주소 명령어 형식1-주소 명령어 형식0-주소 명령어 형식명령어 길이를 줄이는 방법명령어 사이클폰노이만 모델가상 컴퓨터 AccCom의 CPU 구성가상 컴퓨터 AccCom의 명령어 형식과 데이터 형식가상 컴퓨터 AccCom의 명령어 목록명령어 사이클의 종류인출 사이클실행 사이클가상 컴퓨터 프로그램 예제인터럽트(Interrupt)인터럽트의 종류연산의 종류컴퓨터 연산의 종류분기 명령조건 분기조건 분기의 세가지 유형프로시저(Procedure)좋은 명령어 집합(ISA) 구조좋은 ISA가 필요한 이유ISA와 컴파일러의 관계좋은 ISA의 조건
명령어 집합
고급 언어(high-level language)
- 사람이 읽는 언어이다.
- 생산성이 높고 컴파일 오류를 잡아주며 유지 보수가 쉽다.
- 컴파일러 or 인터프리터에 의해 변환되어 컴퓨터에서 실행한다.
- C, Python, Java 등
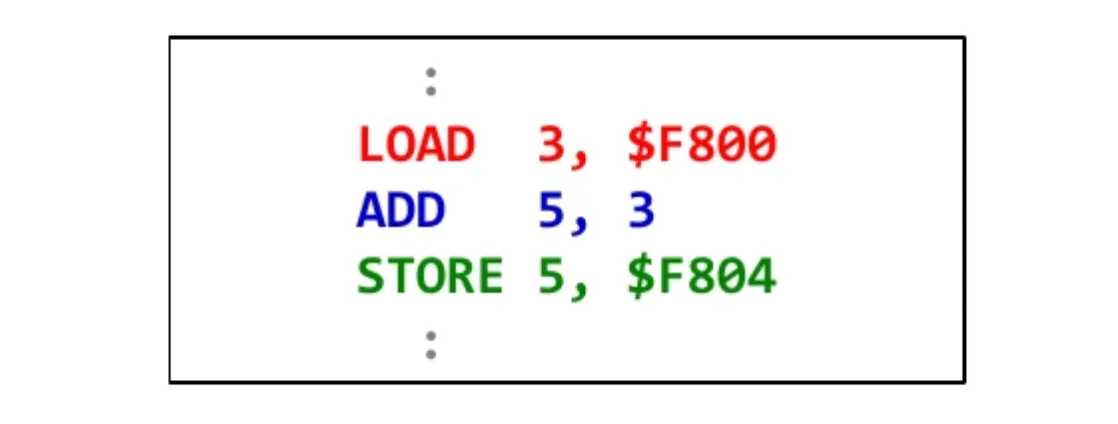
어셈블리어
- 인간이 읽기 쉽도록 기계어를 일대일로 기호로 표현한 언어이다.
기계 명령어(machine instruction)
- 컴퓨터 CPU에서 실행되는 명령어를 2진수 코드로 정의한 것이다.
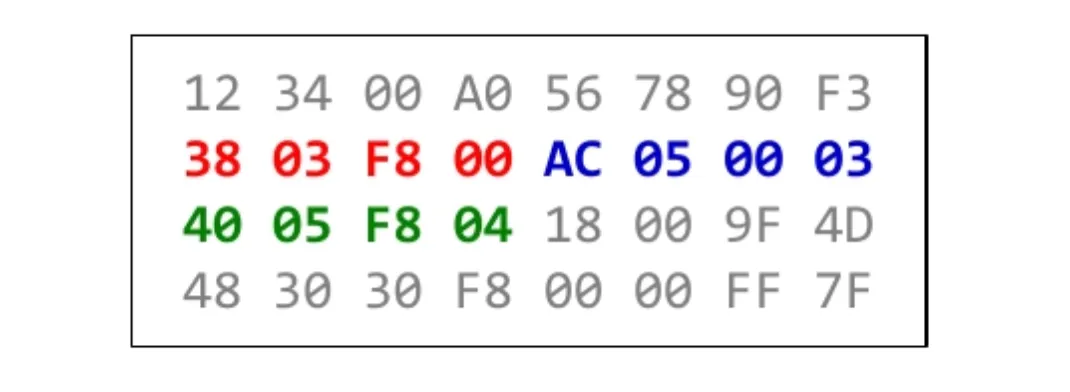
명령어 집합 구조(ISA, Instruction Set Architecture)
- 명령어: 컴퓨터 하드웨어에서 인식되거나 실행될 수 있는 기계 명령어
- 명령어 집합: 특정 CPU를 위해 정의된 명령어의 모음
->연산,데이터 형식,주소 지정 방식등을 명시 - ISA는 작성된
프로그램 <-> 하드웨어사이의 인터페이스에 대한 완전한 명세이다.
->Intel x86,IBM•Motorola PowerPC등
명령어 집합 설계
- 명령어 집합 설계는 하드웨어, 컴퓨터 구성, 프로그래밍 언어, 컴파일러, 운영체제를 모두 고려해야 하는 어려운 작업이다.
설계 시 고려 사항
- 연산의 종류: 전송, 처리, 제어, 입출력 연산을 어떻게 할지
- 명령어 형식: 연산 부호(opcode)의 종류와 형식
- 주소 지정 방식: 명령어에서 데이터의 위치(주소)를 명시하는 방법
- 데이터 형식: 정수, 실수, 논리 데이터, 문자열 등의 취급
명령어 특성
명령어란?
- 컴퓨터가 수행할 수 있는 동작을 2진 코드로 정의한 것
-> 아키텍쳐마다 다양한 형식의 명령어를 사용하여 컴퓨터의 성능을 향상
명령어의 구성: 연산부호 + 피연산자
연산부호(opcode)
- CPU가 실행할 동작을 의미한다.
-> 덧셈, 뺄셈, 저장, 분기 등
피연산자(operand)
- 연산의 대상이 되는 데이터 또는 데이터의 위치
-> 메모리 주소, 레지스터 번호, 상수 값, 입출력 포트
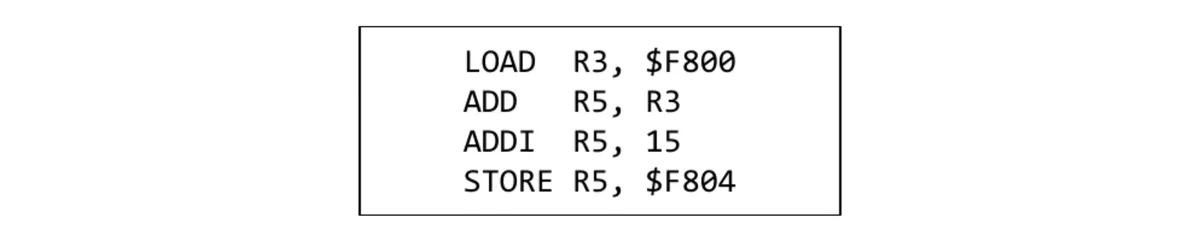
->ADD, LOAD가 연산 부호,R3, R5가 피연산자다.
명령어 길이 형식
고정 길이(fixed-length)
- 명령어 종류/구성요소와 관계없이 모두 동일한 길이의 명령어 형식
- 해석이 쉬워 프로세서 설계가 단순해진다
- 짧게 표현 가능한 명령어도 고정 길이에 맞춰야 해 프로그램에 낭비되는 부분이 발생한다
- RISC(Reduced Instruction Set Computer)에서 사용한다
가변 길이(variable-length)
- 명령어 종류/구성요소에 따라 다양한 길이의 명령어 형식
- 프로그램에 낭비되는 부분 없이 강력한 명령어 도입 가능
- 해석이 어려워 프로세서 설계가 복잡해짐
- CISC(Complex Instruction Set Computer)
피연산자 수에 따른 명령어 형식
- 3-주소 명령어 형식: 피연산자 3개 (결과, 소스1, 소스2)
- 2-주소 명령어 형식: 피연산자 2개
- 1-주소 명령어 형식: 피연산자 1개. 누산기(Accumulator) 컴퓨터
- 0-주소 명령어 형식: 피연산자 없음. 스택 컴퓨터
3-주소 명령어 형식
- 형식:
opcode, 결과, 소스1, 소스2=>결과 = opcode(소스1, 소스2)
python
Y = A x B + C x D 를 표현

1. MUL R1, A, B   # R1 <- A x B
2. MUL R2, C, D   # R2 <- C x D
3. ADD Y, R1, R2 # Y <- R1 + R2- 특징: 명령어의 길이가 길어지고, 명령어의 수는 적어진다.
2-주소 명령어 형식
- 형식:
opcode, 소스 및 결과, 소스2=>operand1 = opcode(operand1, operand2)
python
Y = A x B + C x D 를 표현

1. LOAD R1, A    # R1 <- A
2. MUL R1, B     # R1 <- R1 x B
3. LOAD R2, C    # R2 <- C
4. MUL R2, D     # R2 <- R2 x D
5. ADD R1, R2    # R1 <- R1 + R2
6. STORE Y, R1 # Y <- R1- 명령어는 짧아지고, 명령어 수는 늘어난다.
3-주소는 결과를 따로 둘 수 있어 소스 값을 보존하지만, 2-주소는 소스가 덮어씌워진다.
1-주소 명령어 형식
- 형식:
opcode, 피연산자=>Acc = opcode(Acc, operand) - 누산기(Acc)가 언제나 한쪽 소스이자 결과기에 명령어에서 생략한다.
python
Y = A x B + C x D 를 표현

1. LOAD A    # Acc <- A
2. MUL B     # Acc <- Acc x B
3. STORE T   # T <- Acc  (임시저장)
4. LOAD C    # Acc <- C
5. MUL D     # Acc <- Acc x D
6. ADD T     # Acc <- Acc + T
7. STORE Y # Y <- Acc- 명령어는 가장 짧고, 명령어 수는 가장 많다.
- 초기 컴퓨터에서 쓰였고 지금은 찾아보기 힘들다.
0-주소 명령어 형식
- 스택을 사용하는 계산기에서 사용하는 명령어 형식
->ADD,MUL등 연산자는Stack에서 두 개의 데이터를pop하여 계산하고 결과를push한다. - 중위 표기식 -> 후위 표기식으로 바꿔 순서대로 실행한다.
python
Y = A x B + C x D

-> A B x C D x +

1. PUSH A
2. PUSH B
3. MUL        # A x B 를 push
4. PUSH C
5. PUSH D
6. MUL        # C x D 를 push
7. ADD        # A x B + C x D 를 push
8. POP Y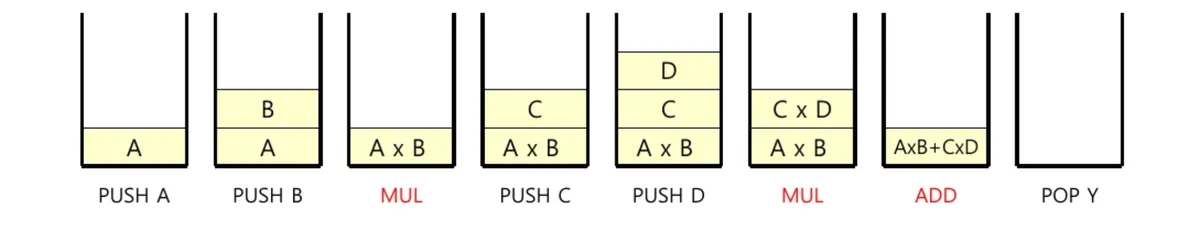
- 연산 명령에 피연산자가 없어 가장 짧다.
명령어 길이를 줄이는 방법
1. 메모리 주소 대신 레지스터 주소 사용
- 레지스터는 개수가 매우 적어서 몇 비트면 번호를 표현할 수 있다.
- 메모리 주소는 수십 비트가 필요하다.
2. 2-주소 명령어 형식
- 피연산자 하나가
소스 및 결과로 지정되기에 3-주소 명령어보다 짧다.
3. 1-주소 명령어 형식의 묵시적 피연산자 사용
- 피연산자에서 누산기를 생략함으로써 명령어 길이가 짧아진다.
명령어 사이클
폰노이만 모델
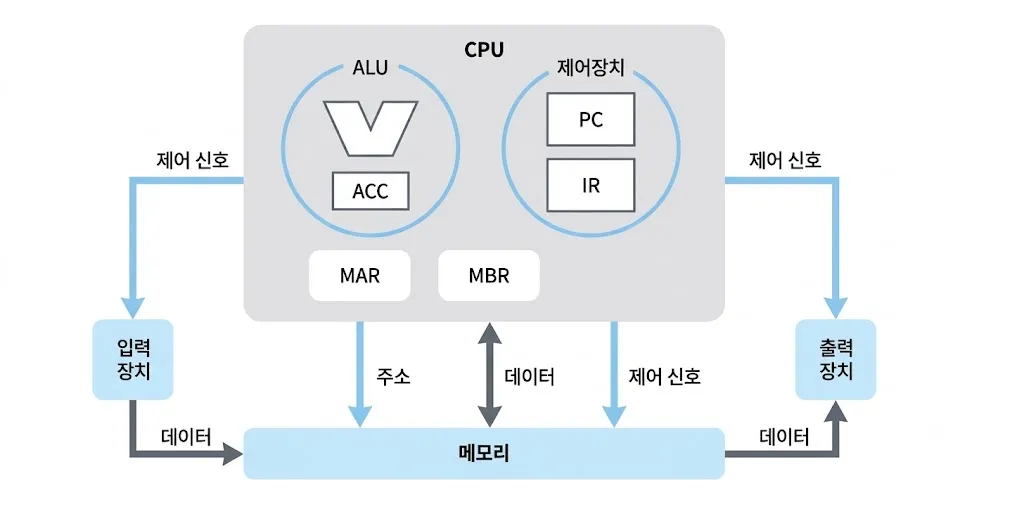
- CPU, 메모리, 입출력장치로 구성
가상 컴퓨터 AccCom의 CPU 구성
-
제어장치
->PC(Program counter): 프로그램 계수기(다음 명령어 주소)
->IR(Instruction register): 명령어 레지스터(지금 실행할 명령어) -
연산장치
->ACC(Accumulator): 누산기 -
메모리 인터페이스
->MAR(Memory address register): 메모리 주소 레지스터(접근할 주소)
->MBR(Memory buffer register): 메모리 버퍼 레지스터(읽고 쓸 데이터)
가상 컴퓨터 AccCom의 명령어 형식과 데이터 형식
-
명령어 형식
-> 16bit 고정 길이 명령어
-> 메모리 용량 :4kbyte
-> 메모리 주소:0x0000 ~ 0x0FFF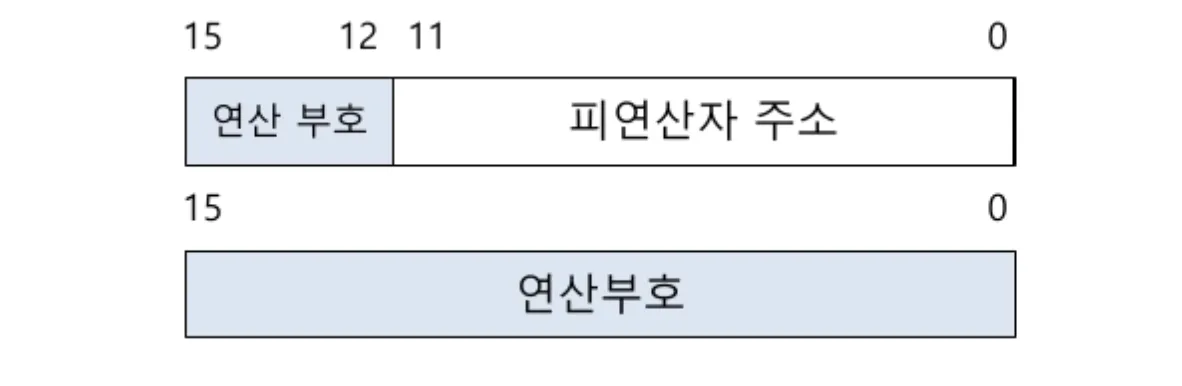 연산부호: 4비트, 피연산자 주소: 12비트
-
데이터 형식
-> 16bit 부호-크기 방식의 정수
-> 정수:-32767~-0,0 ~ 32767
-> 연산:add,sub,mul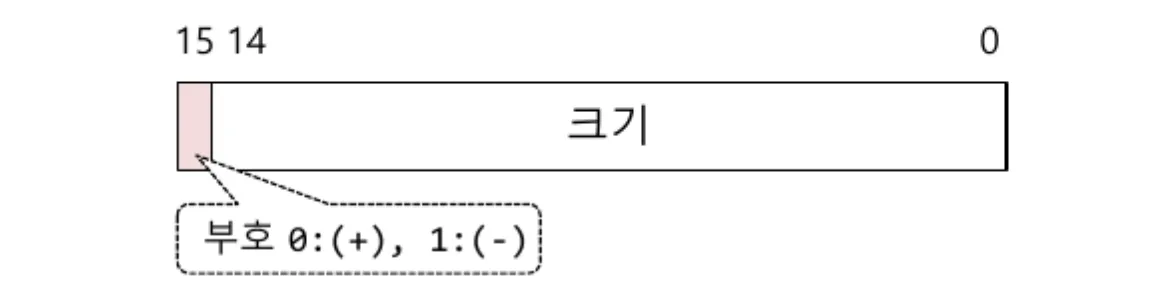
가상 컴퓨터 AccCom의 명령어 목록
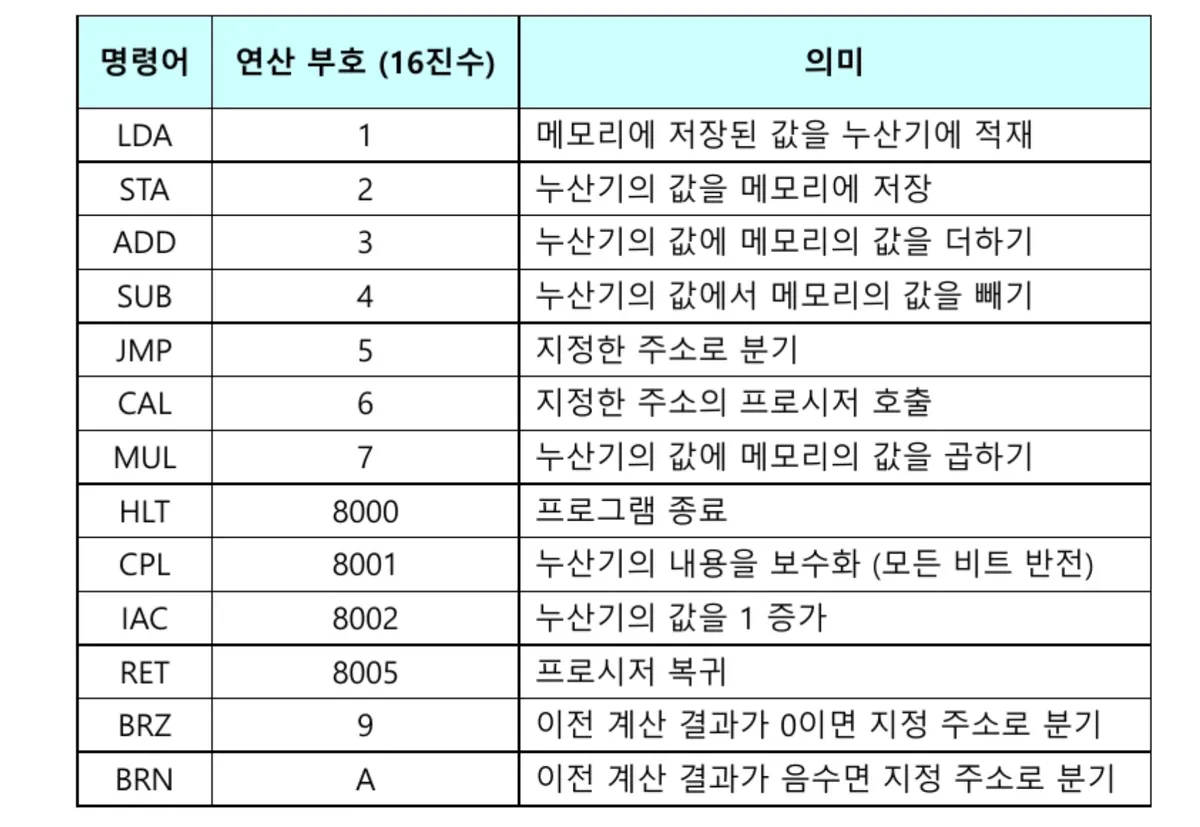
명령어 사이클의 종류
- 인출 사이클(fetch): 메모리에서 CPU로 명령어를 가져오는 단계
- 실행 사이클(execution): CPU에서 명령을 실행하는 단계
- 인터럽트 사이클(interrupt): 인터럽트 발생 시 서비스 루틴을 실행하는 단계
프로그램 실행=인출 -> 실행 -> 인출 -> 실행...의 반복
인출 사이클
- 실행할 명령어를 메모리에서 읽어 CPU로 가져오는 단계
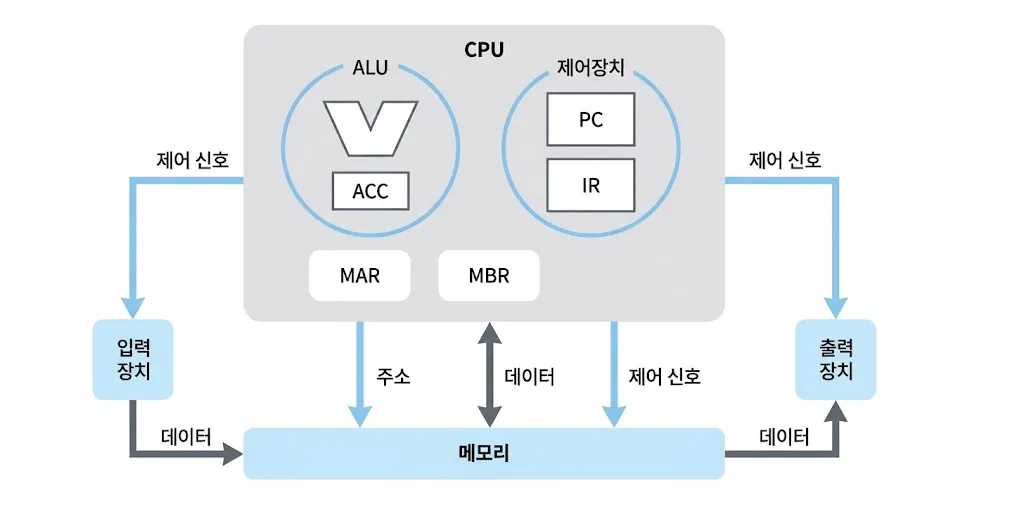
python
1. PC에 저장된 명령어의 메모리 주소를 MAR에 보낸다.
2. 메모리는 MAR이 지정한 주소에 있는 데이터를 MBR에 저장한다.
3. MBR의 명령어를 IR에 저장한다.
4. PC가 다음 명령어 주소를 가리키도록 갱신한다.
실행 사이클
- IR에 저장된 명령어를 실행하는 단계 (명령어에 따라 과정이 다르다)
python
데이터 읽기 명령의 경우 (명령어 1310 => LDA 310 => Acc <- M[310])

1. 프로세서가 데이터가 있는 메모리 주소(310)를 MAR에 저장한다
2. 메모리가 MAR이 지정한 주소에 있는 데이터를 MBR에 저장한다
3. MBR에 저장된 데이터를 Acc에 저장한다

메모리 -> MBR -> Acc
python
데이터 쓰기 명령의 경우 (명령어 23A0 => STA 3A0 => M[3A0] <- Acc)

1. 프로세서가 데이터를 저장할 메모리 주소(3A0)를 MAR에 저장한다.
2. Acc의 데이터를 MBR에 저장한다.
3. MAR이 지정하는 메모리 주소에 MBR의 내용을 저장한다.

Acc -> MBR -> 메모리
python
덧셈 명령의 경우 (명령어 33F0 => ADD 3F0 => Acc <- Acc + M[3F0])

1. IR에 저장된 명령어에서 피연산자 주소 부분(3F0)을 MAR에 저장한다.
2. MAR이 지정하는 주소에 있는 데이터를 MBR에 저장한다.
3. MBR의 데이터와 Acc의 데이터를 더하고 그 결과를 Acc에 저장한다.
가상 컴퓨터 프로그램 예제
- 500번지의 값과 502번지 값을 더해 502번지에 저장, 300번지로 분기하기
- 500번지와 502번지에는 0001과 0002가 저장되어 있다고 가정
tsx
M[502] <- M[500] + M[502]
GOTO 300
-> 가상 컴퓨터의 프로그램
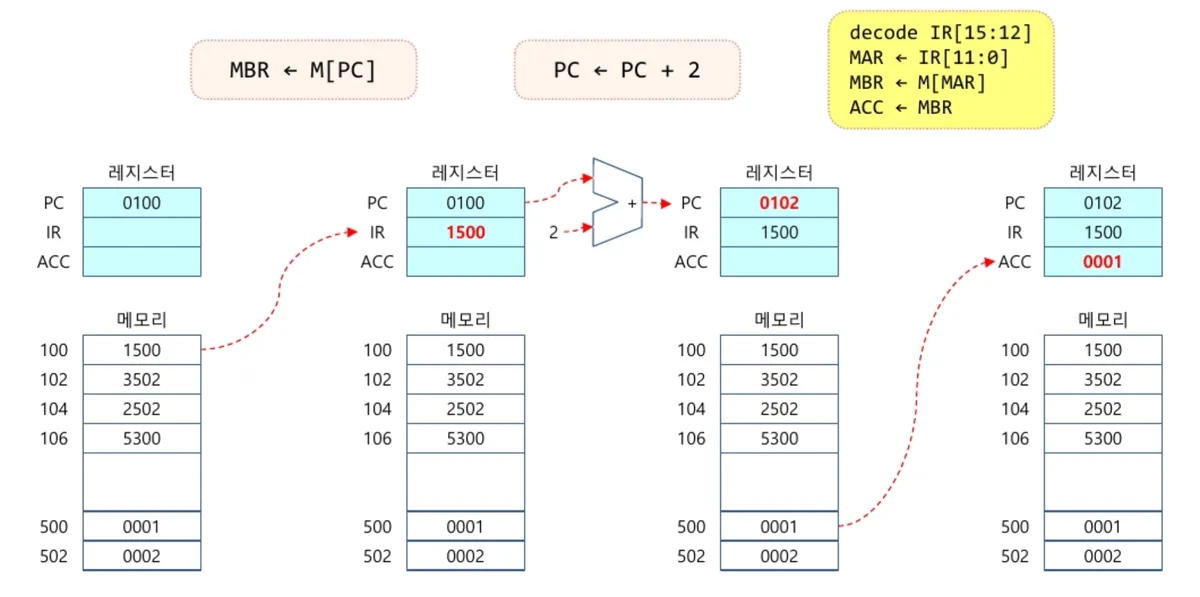
| 메모리 주소 | 바이너리 명령어 | 어셈블리 명령어 |
|---|---|---|
| 100 | 1500 | LDA 500 |
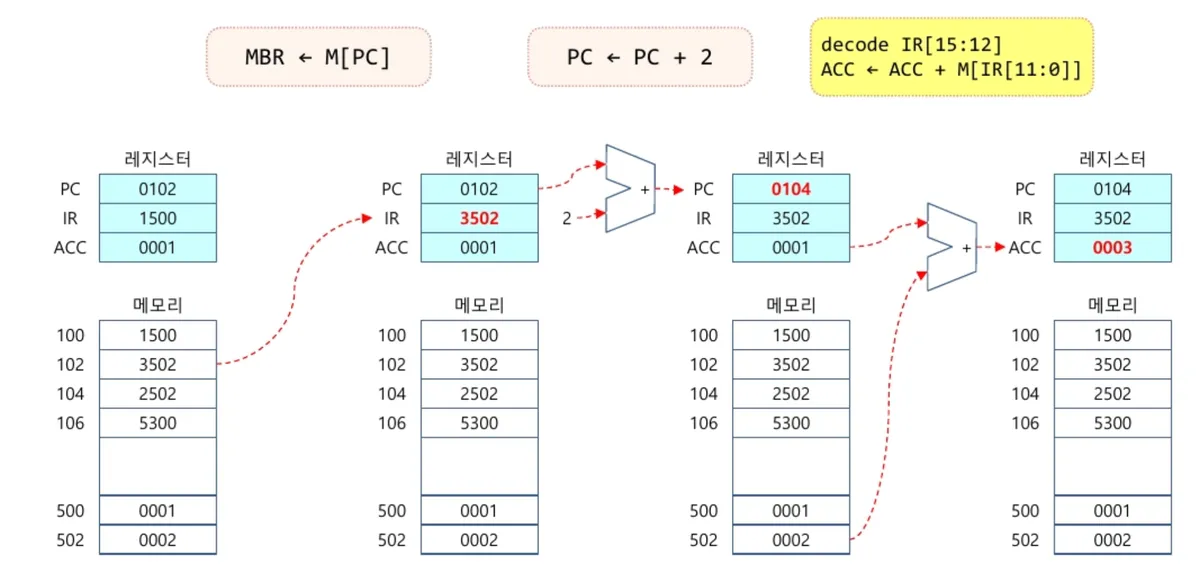
| 102 | 3502 | ADD 502 |
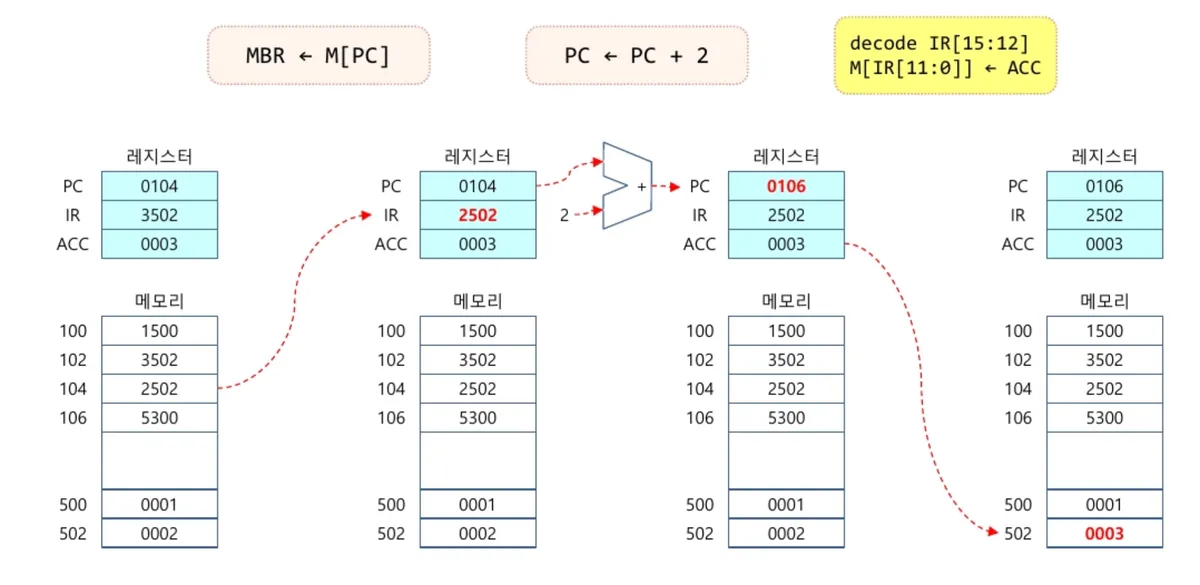
| 104 | 2502 | STA 502 |
| 106 | 5300 | JMP 300 |
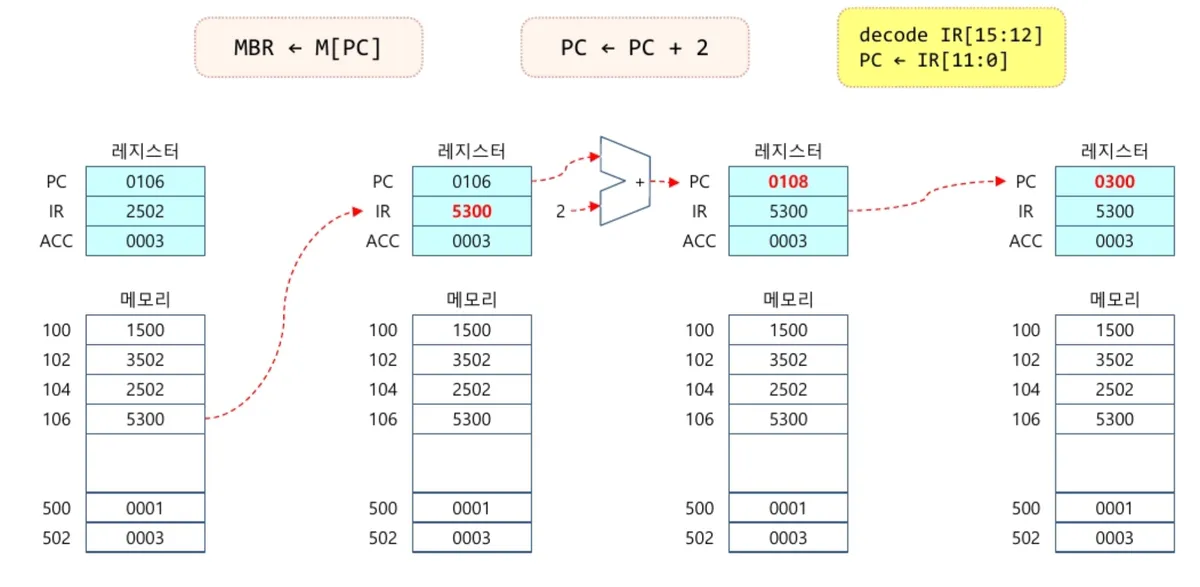
LDA 500명령 수행 시
PC가0100을 가리킴IR에0100번지 명령어인1500(LDA 500)을 올림PC는 다음 주소인0102를 가리킴IR이500번지의 데이터를Acc에 올림
ADD 502명령 수행 시
PC가0102번지를 가리킴0102번지의 명령어3502(ADD 502)를IR이 가져옴PC는 다음 명령어인0104를 가리킴IR이502번지 데이터0002를Acc에 더해서 저장함
STA 502명령 수행 시
PC가0104를 가리킴0104번지 명령어인2502(STA 502)가IR에 올라옴PC는 다음 명령어인0106을 가리킴IR이502번지에Acc의 데이터인0003을 저장함
JMP 300명령 수행 시
PC가0106번지를 가리킴0106번지 명령어인5300(JMP 300)이IR에 올라옴PC는 다음 명령어인0108을 가리킴5300(JMP 300)명령어를 수행해PC가0300을 가리킴
인터럽트(Interrupt)
- CPU가 내부나 외부에서 일어나는 갑작스런 사건에 대응하는 기능이다.
- 인터럽트가 발생하면
상태 레지스터에 인터럽트 발생을 표시한다. - CPU는 명령어 실행이 끝날 때 마다 인터럽트가 있는지 확인한다.
- 있으면 현재 CPU 상태를 저장하고 해당 인터럽트 서비스 루틴을 실행한다.
- 서비스 루틴이 끝나면 이전 상태로 복귀한다.
인터럽트의 종류
내부 인터럽트
- 하드웨어 고장
- 실행할 수 없는 명령어
- 명령어 실행 오류 (0으로 나누기 등)
- 사용 권한 위배
외부 인터럽트
- 타이머 인터럽트: 프로세스 스케줄링 또는 예약 작업 처리
- 입출력 인터럽트: 입출력 장치의 상태 변화 알림
연산의 종류
컴퓨터 연산의 종류
전송 연산
- CPU내의 레지스터와 메모리 사이의 데이터를 교환하는 연산
->LDA,STA
처리 연산
- 산술논리장치를 이용하여 데이터를 조작하는 연산
->ADD,SUB,MUL,CPL,IAC
제어 연산
- 프로그램의 실행 순서를 제어하는 연산
->JMP,HLT,CAL,RET,BRZ,BRN
입출력 연산
- CPU내의 레지스터와 외부 장치 사이의 데이터를 이동하는 연산
분기 명령
체인(chain) 방식
- 모든 명령어가 항상 다음 명령어의 위치를 명시
- 초기 컴퓨터에서 사용
분기(branch) 방식
- 명령어는 항상 순차적으로 실행된다고 가정
-> PC(Program Counter) 도입
-> PC가 가리키는 명령어를 읽어오고, PC가 다음 명령어를 가리키도록 PC값을 변경 - 명령어 실행 순서를 바꾸고 싶으면 분기 명령 사용
-> 무조건 분기: PC값만 변경하면 됨
-> 조건 분기: 지정된 조건을 만족하는 경우에만 PC값을 변경
조건 분기
조건 분기 명령의 두 단계 과정
- 검사 조건 생성
-> 명시적 조건: CMP와 같은 조건 비교 명령어 사용
-> 묵시적 조건: 이전에 수행한 산술/논리 연산 결과를 조건으로 사용
-> 상태 레지스터에 조건 결과를 저장 - 조건 판단 및 위치 선택
-> 상태 레지스터의 결과에 따라 분기 결정
상태 레지스터
- 조건 결과 값을 저장하는 공간
- 프로그램 상태 워드(PSW)의 상태 비트:
C(carry),V(Overflow),S(Sign),Z(Zero)
->SUB결과가0이면Z비트가 되고 다음BRZ가Z를 보고 분기한다.
조건 분기의 세가지 유형
- 묵시적 조건 생성 + 분기 명령
SUB+BRZ
python
SUB X, Y
BRZ 114 # 위의 뺄셈 결과가 0이면 114로 이동- 명시적 조건 생성 + 분기 명령
- CMP(Cocmpare) + BRN
python
CMP R1, R2    # R1과 R2를 명시적으로 비교
BRN 210 # R1 - R2 < 0 이면 210으로 이동- 비교 분기 융합 명령
- BGT(Branch on Greater than)
python
BGT R1, R2, 220 # 비교 + 분기를 한 명령어로프로시저(Procedure)
프로시저의 장점
- 프로그램 내의 중복된 코드를 제거
- 프로그램 구현의 상세 내역을 추상화
- 프로그램 가독성 향상
- 프로그래밍 언어의 함수와 같은 역할
프로시저 호출 명령 CALL proc
python
인출 사이클

IR <- M[PC]     # 현재 PC가 가리키는 메모리주소의 명령(CALL proc)을 IR에 가져옴
PC <- PC + ∆    # PC를 다음 명령어(복귀 주소) 위치로 이동 (∆ : 명령어 길이)

실행 사이클

TOS <- PC       # 복귀주소를 TOS(Top Of Stack)에 Push
PC <- proc      # PC값을 이동하고자 하는 프로시저의 시작 주소로 변경
프로시저 복귀 명령 RET
python
인출 사이클

IR <- M[PC]     # RET 명령어를 가져옴
PC <- PC + ∆    # PC가 RET 다음 주소로 넘어감

실행 사이클

PC <- TOS       # 저장해놓은 복귀주소를 TOS에서 꺼내어줌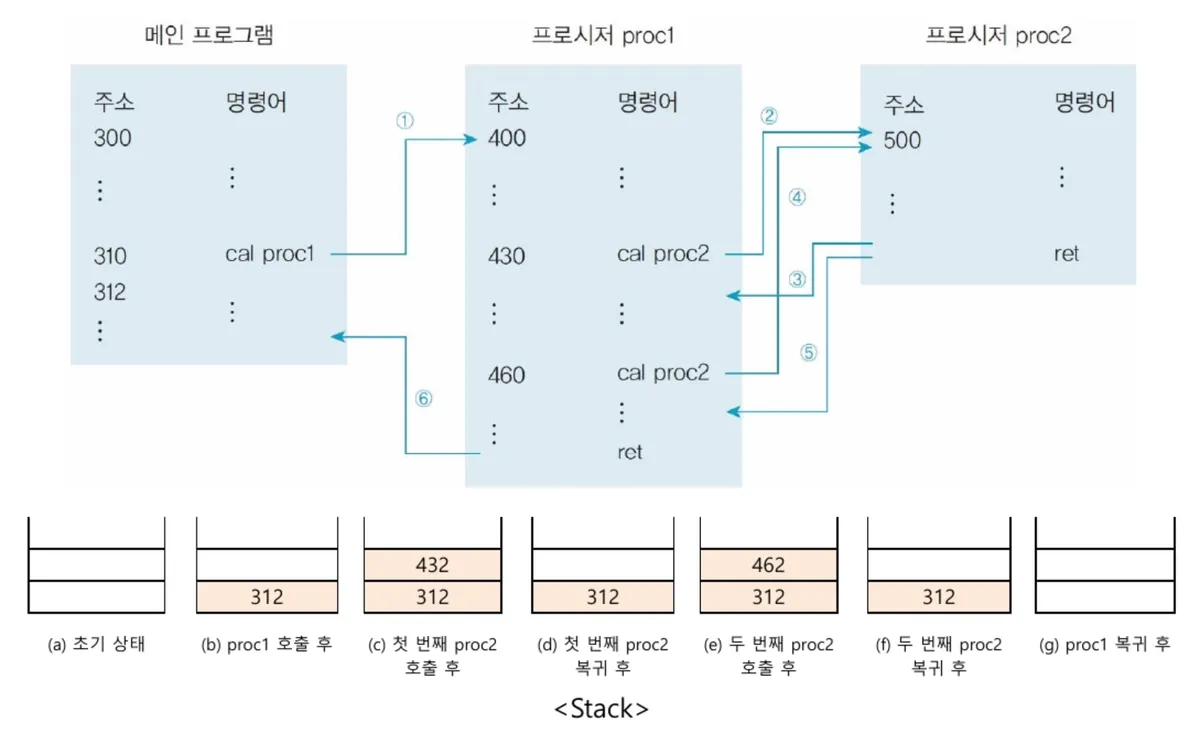
-> 스택을 사용하니 프로시저 호출을 여러번 해도 순서가 엇갈리지 않는다
좋은 명령어 집합(ISA) 구조
좋은 ISA가 필요한 이유
- 하드웨어와 소프트웨어 사이에서의 인터페이스 역할을 한다
- ISA가 나쁘면 하드웨어 구성이 복잡해질 수 있다.
- ISA가 나쁘면 소프트웨어 개발이 어려워질 수 있다.
ISA와 컴파일러의 관계
- 컴파일러의 결과물은 명령어 집합 구조를 따른다.
- ISA가 컴파일러의 효율적인 코드 생성에 영향을 준다.
좋은 ISA의 조건
일관성(Consistency)
- 명령어가 일관된 구조를 가지는 것
- 일부 명령어만 알면 나머지 명령어의 구조를 예측할 수 있어야 함
직교성(Orthogonality)
- 명령어 구성 요소 사이의 독립성을 유지하는 것
-> 명령어의 종류에 따라 피연산자의 사용법이 달라지면 안됨
적절성(Propriety)
- 모든 컴퓨터의 기능은 시스템의 필수 요구 조건에 포함되어야 함
- 본질적이지 않거나 기능과 관계없는 부분은 최소화
초록
앱과 웹을 만들고, 직접 운영하며 기록합니다.
댓글
giscus로 동작하며 GitHub Discussions에 저장됩니다.