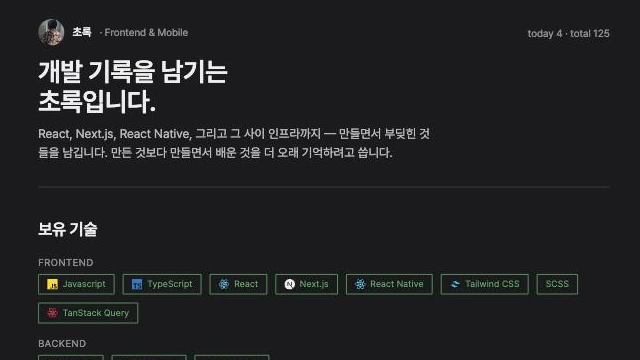
사용 기술
프론트엔드
 Next.js (App Router)
 React 19
 TypeScript
 TanStack Query
백엔드·데이터
 MongoDB Atlas
 MongooseAuth.js (GitHub OAuth)AWS S3
콘텐츠·배포
 remark / rehypeShiki
 Vercelgiscus
프로젝트 개요
Express(SSR) + MongoDB + Docker + EC2로 직접 운영하던 개인 블로그를 Next.js App Router + MongoDB Atlas + Vercel 조합으로 다시 만든 프로젝트이며, 지금 보고 계신 이 사이트입니다. 옛 블로그의 게시글을 실제로 이관해 예전 링크가 끊기지 않은 채로 전환했습니다.
맡은 일
- 기획, 프론트엔드, 백엔드(데이터 모델·API), 배포까지 1인 개발입니다.
- 디자인 시스템도 직접 수립했습니다. 여러 예시 자료를 참고해 Claude Design에서 "Broadsheet"라는 시스템을 만든 뒤, 색·타이포그래피·간격 스케일 가운데 이 사이트에서 실제로 쓰는 범위만 골라 CSS 커스텀 프로퍼티로 옮겼습니다. Tailwind나 CSS-in-JS는 사용하지 않았습니다.
- 그 디자인 시스템을 AI 에이전트에게도 따로 학습시켰습니다. 새 화면을 추가할 때도 색·타이포그래피·간격이 처음 정한 규칙에서 벗어나지 않게 하려는 것이었고, 덕분에 화면이 늘어나도 톤이 흔들리지 않았습니다.
- AI 에이전트를 적극적으로 활용하되 산출물을 그대로 믿지 않는 것을 원칙으로 삼았습니다. 변경마다 "이전 상태 → 무엇을 바꿨나 → 어떻게 확인했나"를 기록으로 남기고, 배포 후에는 프로덕션을 직접 확인해 검증했습니다. 아래 문제 해결 두 건 모두 이 습관에서 나왔습니다.
성과와 한계
- 모든 변경을 "이전 상태 → 변경 → 검증" 형식으로 기록해 두고 있어서 몇 달 전 판단의 이유도 지금 되짚어 볼 수 있습니다.
- 검색은 제목·요약·태그 정규식 매칭이라 본문은 검색되지 않습니다. 글이 늘어나면 전문 검색 인덱스로 옮겨야 합니다.
- 테스트 스위트가 없습니다. 지금은 빌드(타입 체크·린트 포함)가 유일한 정합성 게이트입니다.
주요 기능
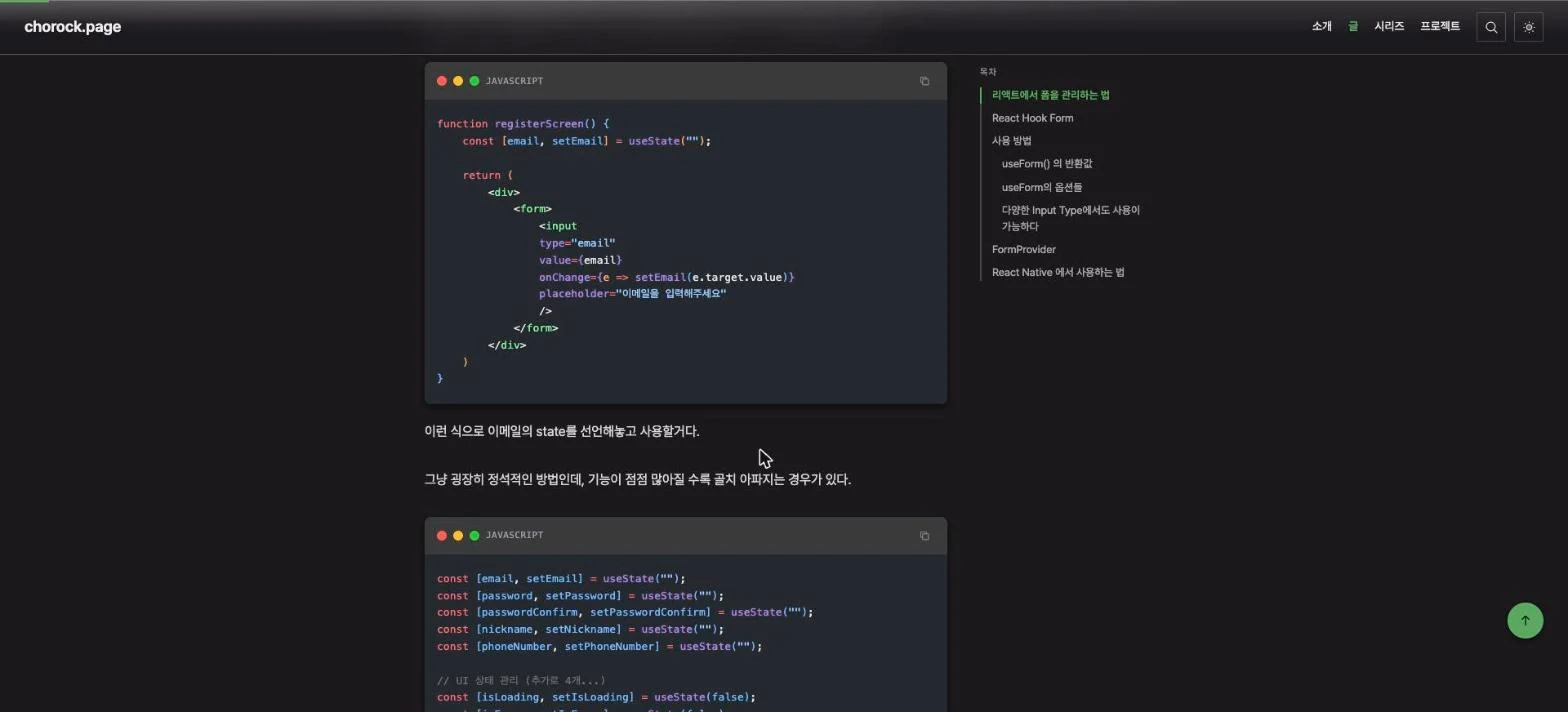
- 글·시리즈·프로젝트 3종 콘텐츠와 마크다운 렌더링: 코드 하이라이팅, 목차 스크롤스파이, 읽는 시간 추정
- GitHub 계정으로 소유자만 통과시키는 인증 뒤에 둔 글쓰기·수정 에디터. 이미지를 붙여넣으면 자동으로 업로드되고, 미리보기는 실제 발행에 쓰는 렌더 파이프라인을 그대로 호출하므로 결과가 어긋나지 않습니다.
- 옛 블로그 게시글 이관: 옛 문서의 식별자를 보존해 upsert 키로 삼았기 때문에 스크립트를 여러 번 다시 실행해도 안전하고, 옛 주소로 접속해도 새 주소로 연결됩니다.
- 글 제목이 들어간 공유 미리보기 이미지를 요청 시 생성
- giscus 댓글, 헤더 검색(Cmd+K), 다크 모드
설계 판단
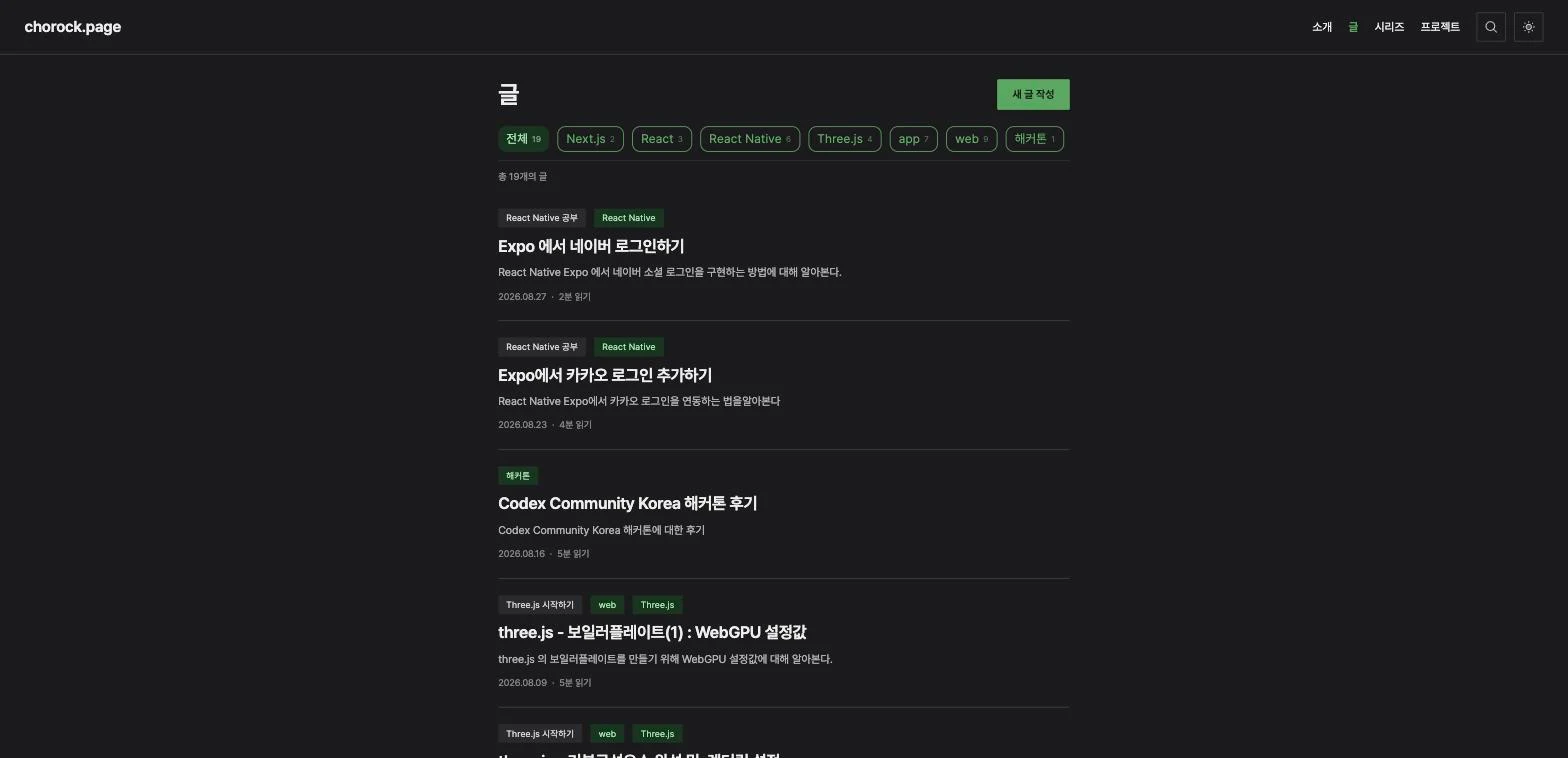
목록 필터링을 서버 왕복에서 클라이언트 처리로
태그를 누를 때마다 DB를 다시 왕복하고 있었습니다. 프로덕션 빌드에서도 클릭 한 번에 140~250ms가 걸렸고, 개발 환경에서는 더 느렸습니다.
서버 페이지네이션을 유지하며 쿼리를 최적화할지, 목록 전체를 한 번만 받아 클라이언트에서 거를지 저울질했습니다. 글이 수십 편 규모여서 전부 받아도 부담이 없다고 판단해 후자를 택했습니다.
클릭 반응이 즉각적으로 바뀌었습니다. 다만 글이 크게 늘면 되돌려야 하는 선택이라 서버 페이지네이션 함수는 지우지 않고 남겨 두었습니다.
인증 확인을 클라이언트로 내려 정적 렌더링을 지킴
로그인 링크를 화면 하단 공통 영역에서 서버 측으로 판별했더니, 그 영역이 모든 페이지에 포함되어 있어 쿠키를 읽는 순간 사이트 전체가 요청마다 렌더링되는 방식으로 넘어갔습니다. 빌드 출력의 라우트 표시가 정적에서 동적으로 바뀐 것을 보고 알아챘습니다.
인증 표시가 필요한 자리만 클라이언트 컴포넌트로 떼어내 세션을 조회하도록 바꿨습니다. 목록·소개·프로젝트 페이지의 정적 렌더링을 되찾았습니다.
보안이 아니라 표시 용도의 분기라 클라이언트로 내려도 안전합니다. 실제 접근 차단은 미들웨어가 맡습니다.
문제 해결
공유 미리보기에 글 제목 대신 내 프로필 사진이 뜨던 문제
메신저에 링크를 공유하면 미리보기가 엉뚱하게 나왔습니다. 캐시 문제로 짐작하기 쉬운 증상이었습니다.
프로덕션 주소를 직접 호출해 보니 미리보기 이미지 주소가 500을 반환하고 있었습니다. 운영 로그를 거슬러 올라가 보니 2주 넘게 모든 글이 같은 상태였습니다. 스크래퍼는 실패한 이미지 대신 페이지의 첫 번째 이미지, 즉 작성자 프로필 사진을 가져갔던 것입니다. 런타임 로그에서 폰트 파일을 찾지 못한다는 오류를 확인했고, 원인은 이미지 생성에 쓰는 한글 폰트를 실행 시점에 디스크에서 읽는데 해당 폴더가 서버리스 함수 번들에 포함되지 않는다는 것이었습니다.
빌드 도구가 이 읽기를 추적하지 못해 경고조차 없었고, 사이트 공용 이미지 하나는 빌드 시점에 미리 만들어져 정상이었던 탓에 문제가 더 가려져 있었습니다.
번들에 폰트를 명시적으로 포함시켜 해결했습니다. 폰트를 찾지 못하더라도 500 대신 글자 없는 이미지라도 응답하도록 바꿔, 같은 실패가 재발해도 프로필 사진이 노출되지 않게 했습니다. 배포 후 실제 이미지를 내려받아 한글 제목이 들어간 것까지 확인했습니다.
상세 페이지 진입이 느리던 문제
원인이 하나가 아니었습니다. 셋을 분리해 각각 처리한 뒤에야 체감이 달라졌습니다.
첫째, 페이지가 매 방문마다 DB를 조회하고 마크다운을 다시 컴파일하고 있었습니다. 미리 생성해 두고 주기적으로 갱신하는 방식으로 바꿨습니다.
둘째, 메타데이터 생성과 페이지 본문이 같은 글을 각각 조회해 한 번의 요청에 중복 쿼리가 나가고 있었습니다. 요청 단위 캐시로 묶었습니다.
셋째, 소유자 전용 버튼을 그리려고 부른 인증 조회가 이 페이지를 요청마다 렌더링하는 방식에 묶어 두고 있었습니다. 위 설계 판단과 같은 방식으로 분리했습니다.
검색엔진이 글 목록 2페이지 이후로 넘어가지 못하던 문제
서치 콘솔에 "발견됨 - 현재 색인이 생성되지 않음"이 22건 쌓여 있었습니다. 짐작에 의존하지 않고 사이트의 모든 페이지를 렌더된 HTML 그대로 받아 글 링크를 전수 수집한 뒤 사이트맵과 대조했습니다. 당시 글 19편 중 5편이 어디에서도 링크되지 않은 고아 페이지였습니다. 목록은 글을 다섯 편씩 나눠 보여 주는데 페이지 번호가 버튼이어서, 자바스크립트를 실행하는 크롤러조차 2페이지로 넘어갈 방법이 없었습니다.
페이지 번호를 실제 앵커로 바꾸되 클릭하면 기존 클라이언트 페이지네이션이 그대로 동작하게 해 사용자 경험은 유지했고, 크롤러가 따라갈 정적 페이지 라우트를 따로 만들었습니다. 수정 후 빌드 산출물 전체에서 같은 대조를 다시 실행해 19편 전부에 링크가 닿는 것을 확인했고, 배포 후 라이브에서도 재확인했습니다.
스크린샷